大家好,我是 Maple,昨天(4)很榮幸能到台灣人工智慧學校(TAIA)小聚去分享自己對於 Context 管理的一些想法,活動本身是圍繞著企業與他們需要的 AI 解方,我的角度是從比較個人出發,分享在 AI 時代,企業該怎麼提供 AI 工具才能符合可觀測性及可稽核性,以及分享了在使用 AI 工具的 Context 管理技術,可以透過企業內訓的方式讓員工更正確的使用 AI,讓成本效益提升
很感謝 Connyn Chang 的邀請讓我有機會可以跟大家分享
這是一場 25 分鐘的分享,內容有點長,我把簡報及摘要分享出來,如果你對 Context Engineering 在這個現代是否還有價值、如何透過 Harness(Skills, Subagents, Hooks)來做 Context 管理有興趣的話,歡迎你把這篇讀下去:)
在談企業的解方之前,先談企業在意什麼
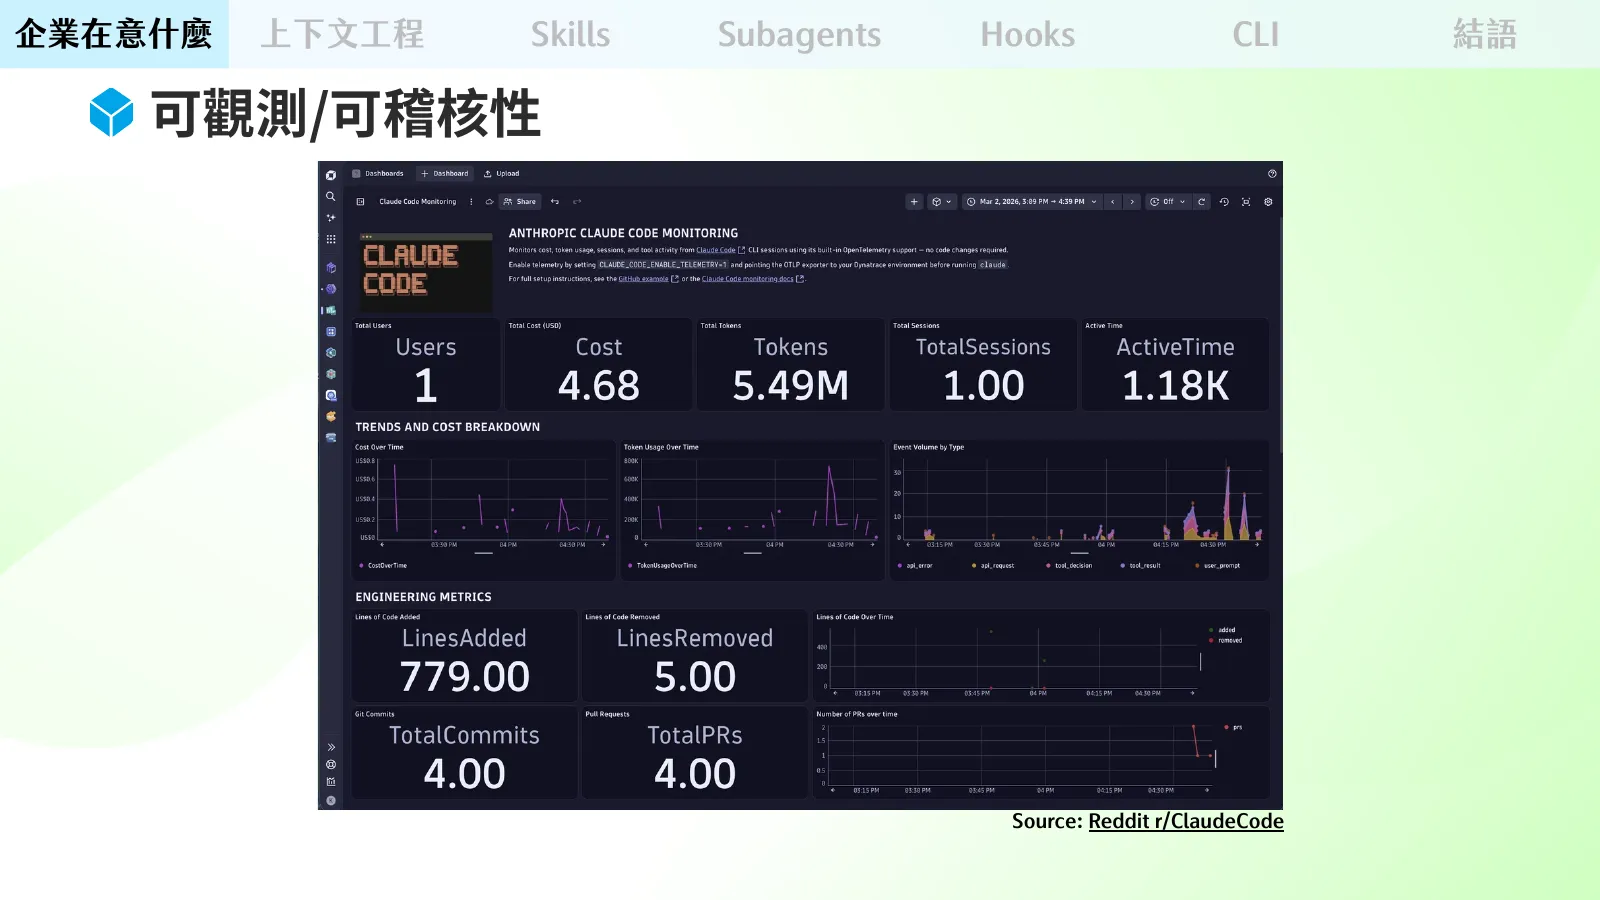
我認為企業在意的事情,要嘛跟人有關,要嘛跟錢有關,通常一間企業會希望事情都完全透明,能夠知道「什麼人」在「什麼時候」做了什麼,還有最重要的是不要侵權,同時也以整間公司可以持續營運獲利下去為目標
在 AI 時代,我相信重視的事情沒有變,企業仍然希望提供 AI 資源的同時,知道自己的員工用 AI 做了什麼,以及使用掉的 token 是否真的有換來對應的輸出,畢竟我相信大家多少有點概念,不走個人訂閱的話,AI token 要價不菲
AI 使用的可觀測性或可稽核性
我覺得其實跟人有關的部分,在 AI 工具上是相對簡單的。原因是現在主流的 CLI 基本上都支援 Otel,至少 Claude Code 跟 Codex 都有,所以接上去之後企業就可以很好的知道員工怎麼使用 AI,只要幾個環境變數打開就好了。所以我今天會比較著重在錢的這塊,也就是怎麼樣把 AI 工具使用的更有效益,就能降低成本,換來更多獲利
Context 的組成
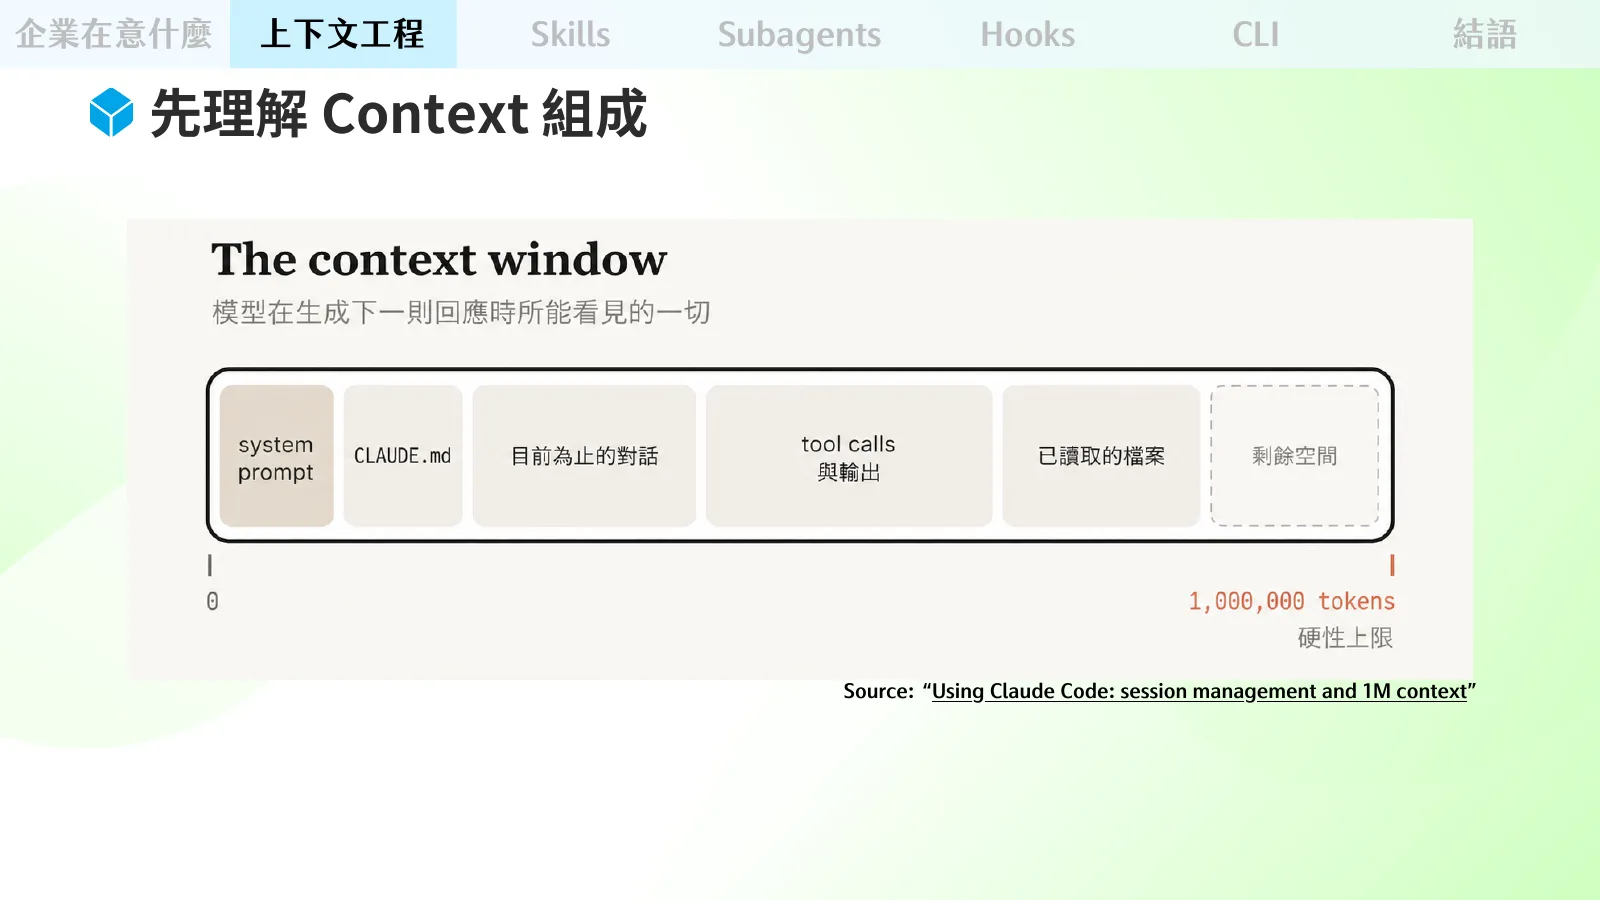
在開始談管理之前想回顧 Context 是怎麼組成的,Context 其實就是模型能看到的所有內容,可以想像成他是一個有限的箱子,每下一次 prompt 都在為箱子裡的東西付錢,而箱子越滿就會越貴。所以如果塞了不必要的東西,就會一直在為那些不必要的內容付錢,因此做管理的目的及目標,就是盡可能只往箱子在必要的時候塞必要的東西,這就叫 Context Engineering
過時的 Context Engineering?
到這裡,可能大家會有個疑惑,都已經 2026 年 8 月了誰還在談 Context Engineering 啊!從 GPT 3.5 時代至今,我們從 2023 的 Prompt Engineering,到 2026 年 7 月的 Graph Engineering,已經經歷了五個階段, AI 時代不是半年前的東西就已經是舊技術了嗎? 真的還有談的必要嗎?
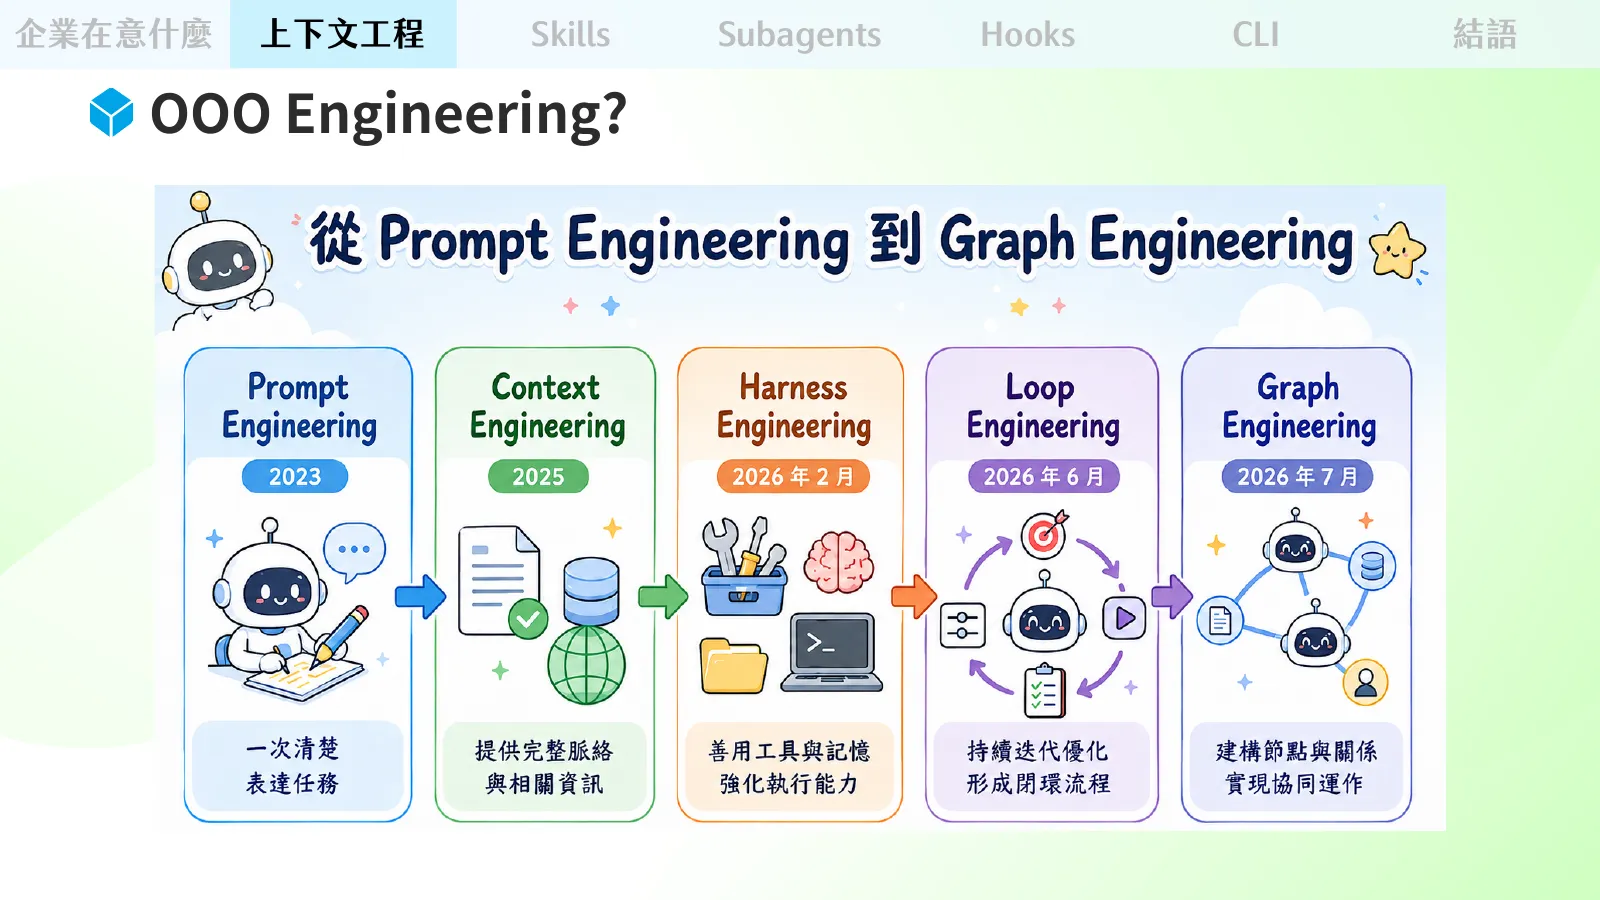
我覺得其實談 Context Engineering 還是有其價值的,因為連 Anthropic 這樣的前沿公司,他們兩週前發了一篇文從 Context Engineering 談針對 Opus 5 做的努力,所以我認為 Context Engineering 現在也還沒過時
為什麼 Context Engineering 重要?
那為什麼 Context Engineering 重要呢,大概可以總結成這三點,首先是模型不可能記住所有東西,盡可能只塞必要的東西,不然會放不下,再來是如果給的 Context 越精準,就能換來更好的輸出。我常說一句話,我覺得現在的 AI 已經很厲害了,至少從 Opus 4.6 / GPT-5.5 開始, 80 % 的開發需求都可以滿足,取決於你給他的 Context 夠不夠,使用現代 AI 應該要假設模型什麼都知道的同時,也什麼都不知道。最後就是最重要的,Context 跟成本有關,不管是個人的訂閱額度,還是企業的 API 成本,沒人會跟錢包過意不去
用一句話來總結,Context Engineering 的核心精神就是「在有限的上下文中,盡可能讓模型獲得更好的輸入,並得到更好的輸出」,而且我覺得因為不管出現什麼什麼 Engineering,都萬變不離其宗,目標都是這個。
如何透過 Skills 來做 Context Engineering
Skills 我相信現代大家都不陌生,大家認為應該是一系列的 markdown 文件、重複指令的 shortcuts、或是別人寫好的 workflow。skills 之所以重要在於有個特性是漸進式揭露,先載入一部分,剩下的只在需要的時候載入,這就很符合 Context Engineering 的精神,因為很多事情不是每個 session 都會用到,比如在開發新功能的時候可能會分好幾次對話,只有最後一次開發完要發 PR,就不需要每個對話都知道 PR description 怎麼寫
再來就是能把已經被驗證的流程記下來,畢竟 AI 是有隨機性的,同樣一件事每次都從頭推是有機會不同,如果能直接有可以跟著做的 skills,就能省下不必要的 token。這其實就很像沒有 AI 的時候,大家會寫文件,寫 wiki 一樣,沒有這個東西就只能通靈,但有了就會比較順利
如何透過 Subagents 來做 Context Engineering
Subagent,我相信大家也不陌生,這是用來管理上下文非常好的機制。有些任務其實我們只在意結果不在意過程,舉幾個例子,問 ChatGPT 今天天氣如何的時候,我們只在意結果,根本不在意他看了哪些網站。或好比你問 Claude 登入是怎麼實作的,對 Claude 來說,他可能要讀很多的檔案才能回答你,但你要的只是結果,這個「讀很多檔案」就是不重要的過程,就可以透過 Subagent 分出去,讓核心重點留在 Context 中就好,就不必為了不重要的過程,在後續的對話中一直付錢
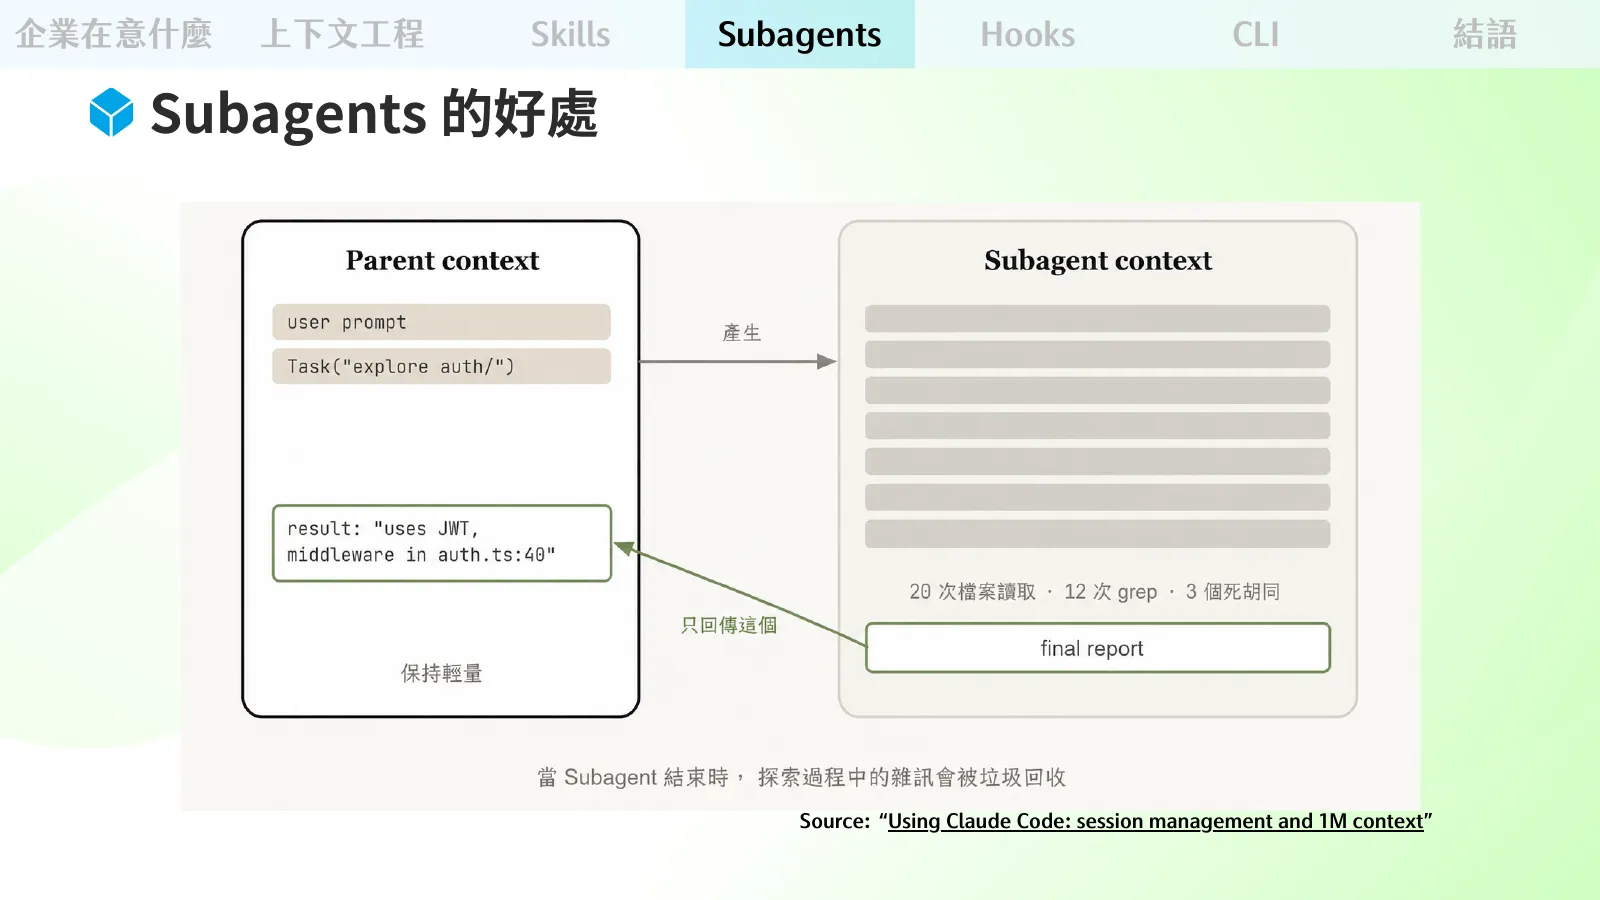
對 AI 來說,每個操作都是在消耗 Context 的預算,因此「只在意結果不在意過程」同樣也能適用於 AI 身上,有點像你外包給 AI,AI 外包給另一個 AI 的套娃
Skills 結合 Subagents 的 Context Engineering
skills 本身還有一些其他的東西,我覺得可能是比較少人知道的。大家在寫 skills 的時候,大部分都是只寫 name 以及 descriptions,包含 superpowers 這個相當知名的 skills 也是。但其實 skills 可以寫的欄位遠遠不止這兩個,可以根據 skills 的類型,設定觸發 skills 的 path、要不要讓模型觸發,或是搭配等下會提到的 hook 等等 ,甚至可以用 subagents 來執行這個 skills,我都稱呼他為 fork agent skills
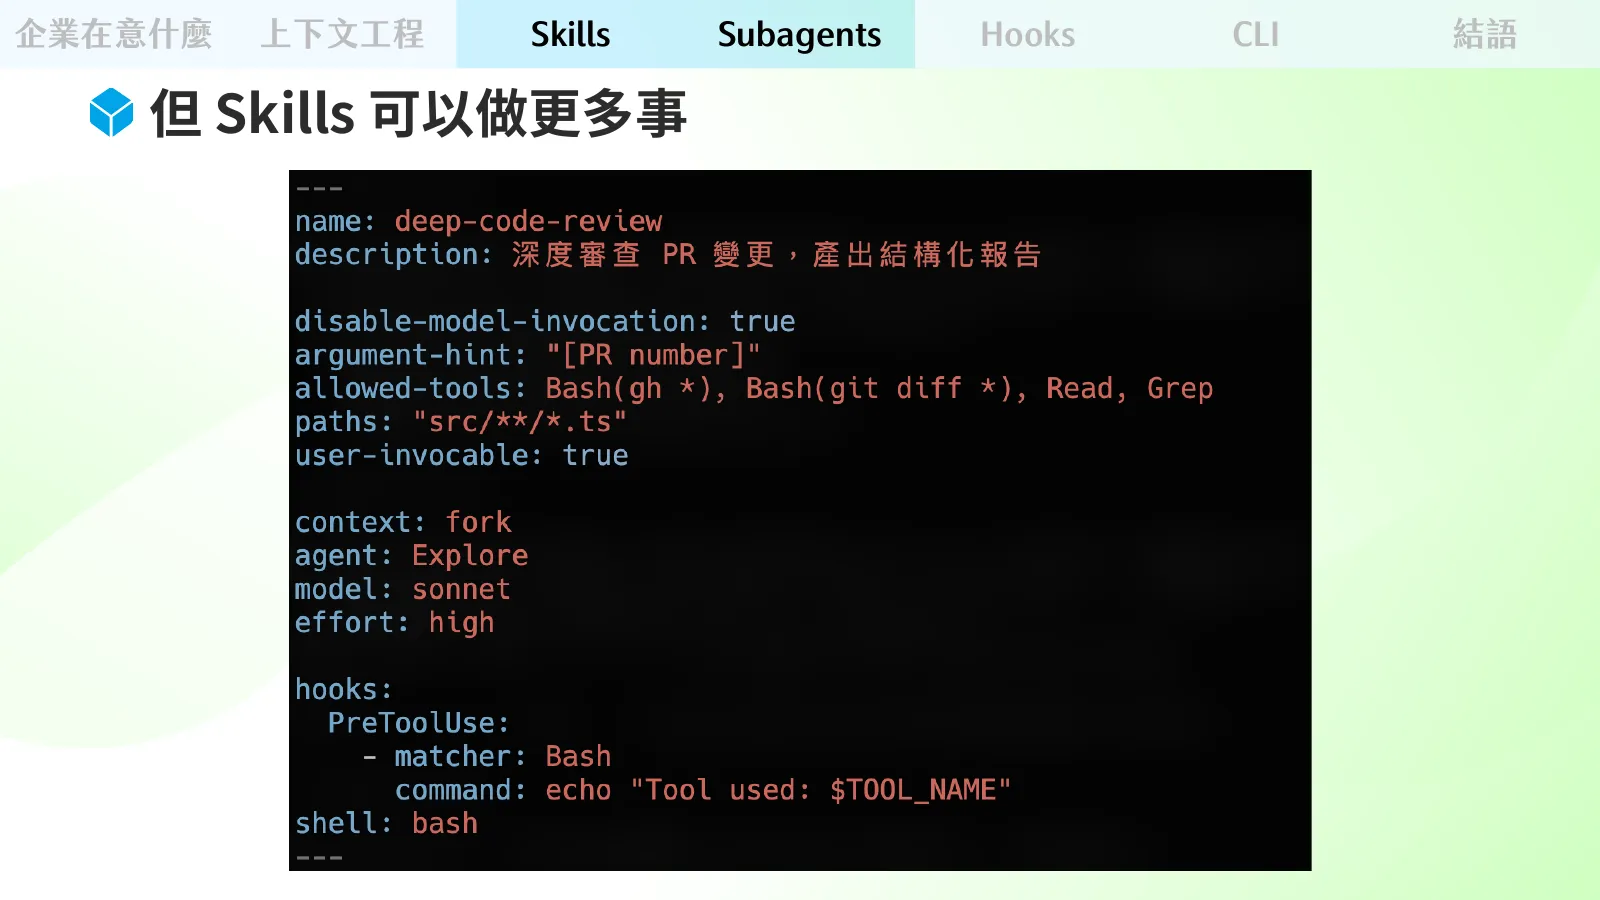
單純的 skills 我會用來替代經常重複告知的內容,或是做一個 tools 給他呼叫,比如我給他去逛 reddit 的能力;而搭配 subagents 的 skills 則是如前面所說,需要一個只在乎結果,例如 code-review 或是 QA 測試。但這裡可能大家會覺得,看起來跟單純使用 subagents 很像,其實有個微小的差異
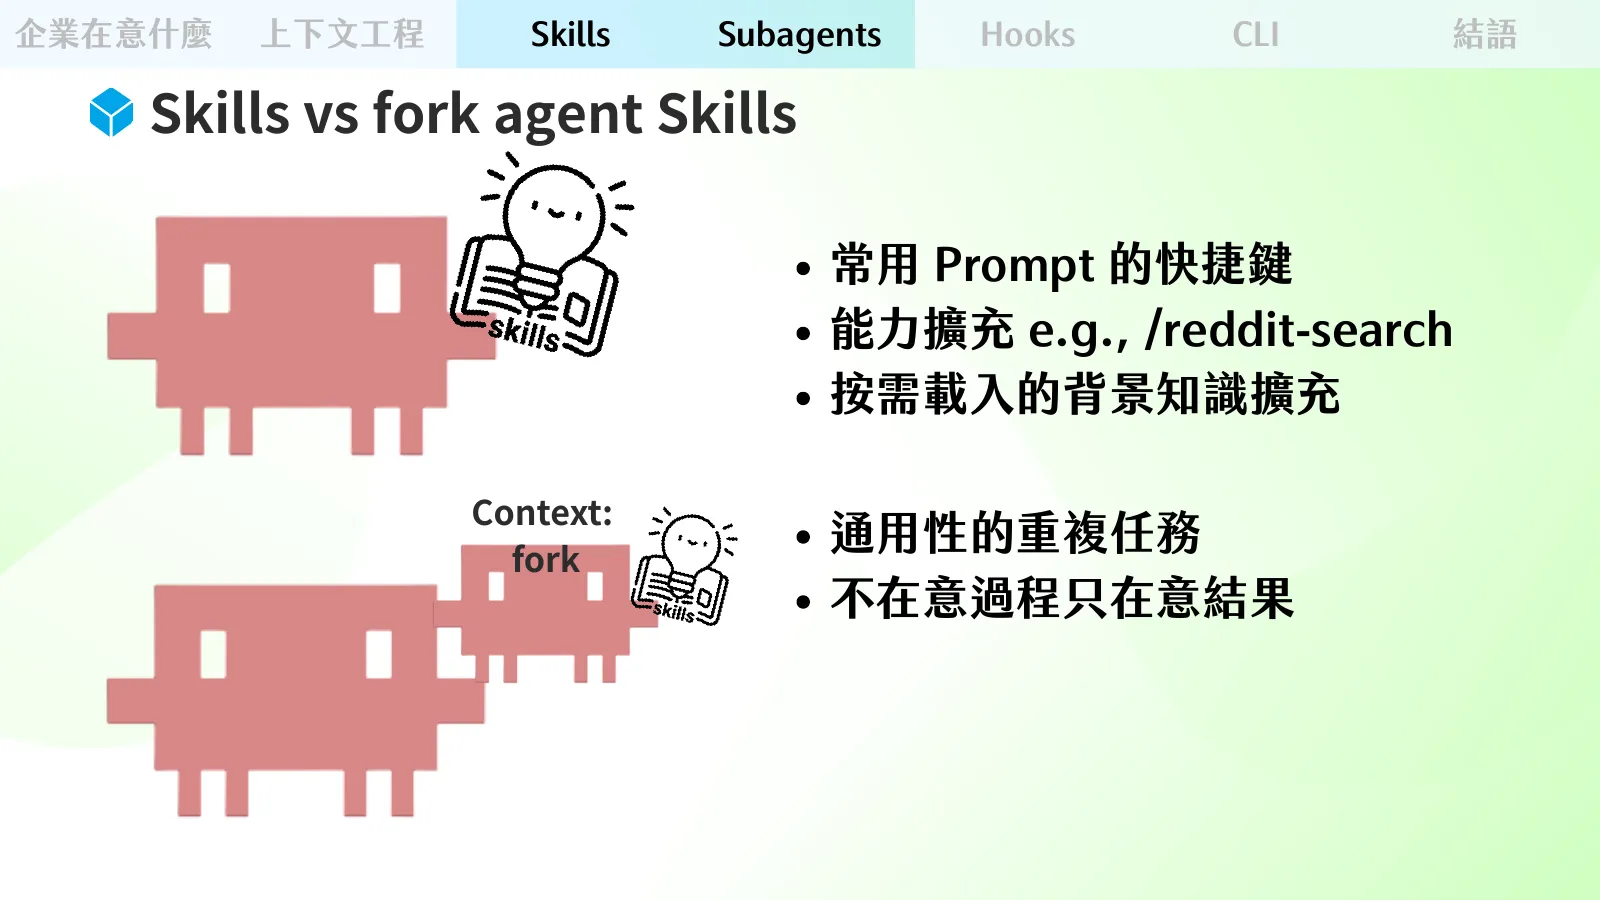
單純讓 Claude 使用 subagents 的差異在於,每次只使用 subagents 的話 prompt 都不一樣,但透過 skills 搭配 subagents,就能把 prompt 固定下來,不會受到隨機生成指令的影響,skills 的內容就是給 subagent 的 prompt
如何透過 Hooks 來做 Context Engineering
談完 Skills 和 Subagents 之後,來接著談 hooks,我覺得 hooks 可以用來管理 Context 的方式比較單純
hooks 在 AI 的語境下基本上跟軟體工程的 hooks 意思差不多,比如 webhook, pre-commit hook,意思是副作用,推出的目的是讓 AI 能夠被一套硬性的規則控制,而不是單純仰賴自然語言祈禱 AI 真的不會做什麼事,比如絕對不要讀我的 API key
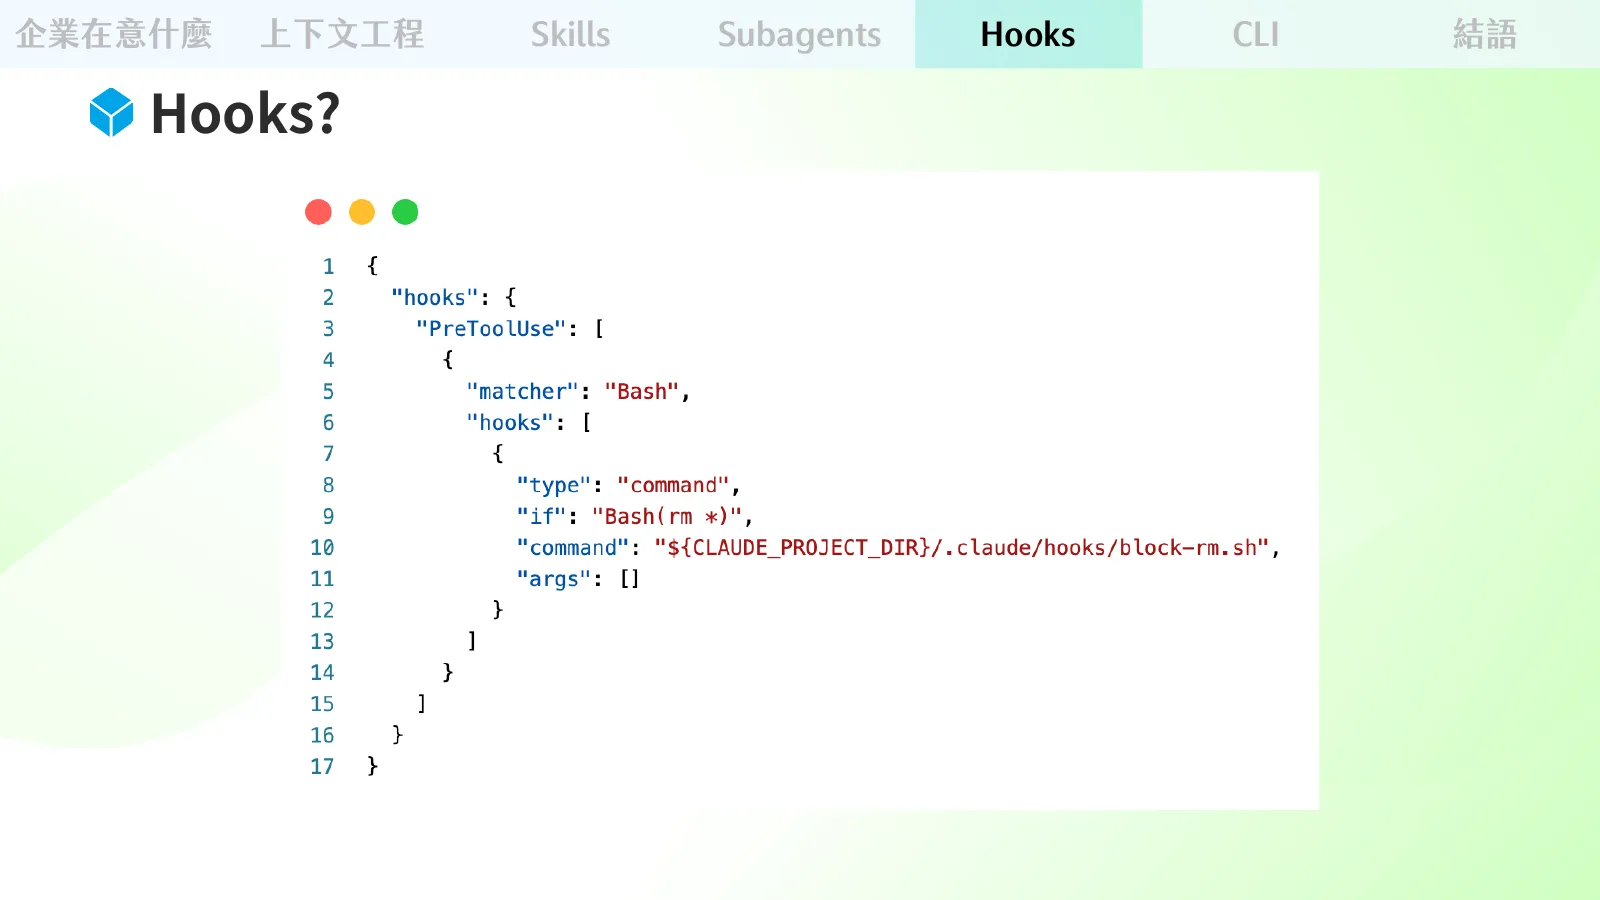
最常見的使用情況是,不准讀環境變數,改完 code 一定要跑 lint 等等,甚至你也可以寫一個 hook 來記錄哪些 skills 跟 MCP 平常根本沒在用,定期回顧哪些是多餘的,然後移除,這也是一種上下文管理,畢竟即便是漸進式揭露,如果完全用不到,skills 一開始揭露的部分也是多餘
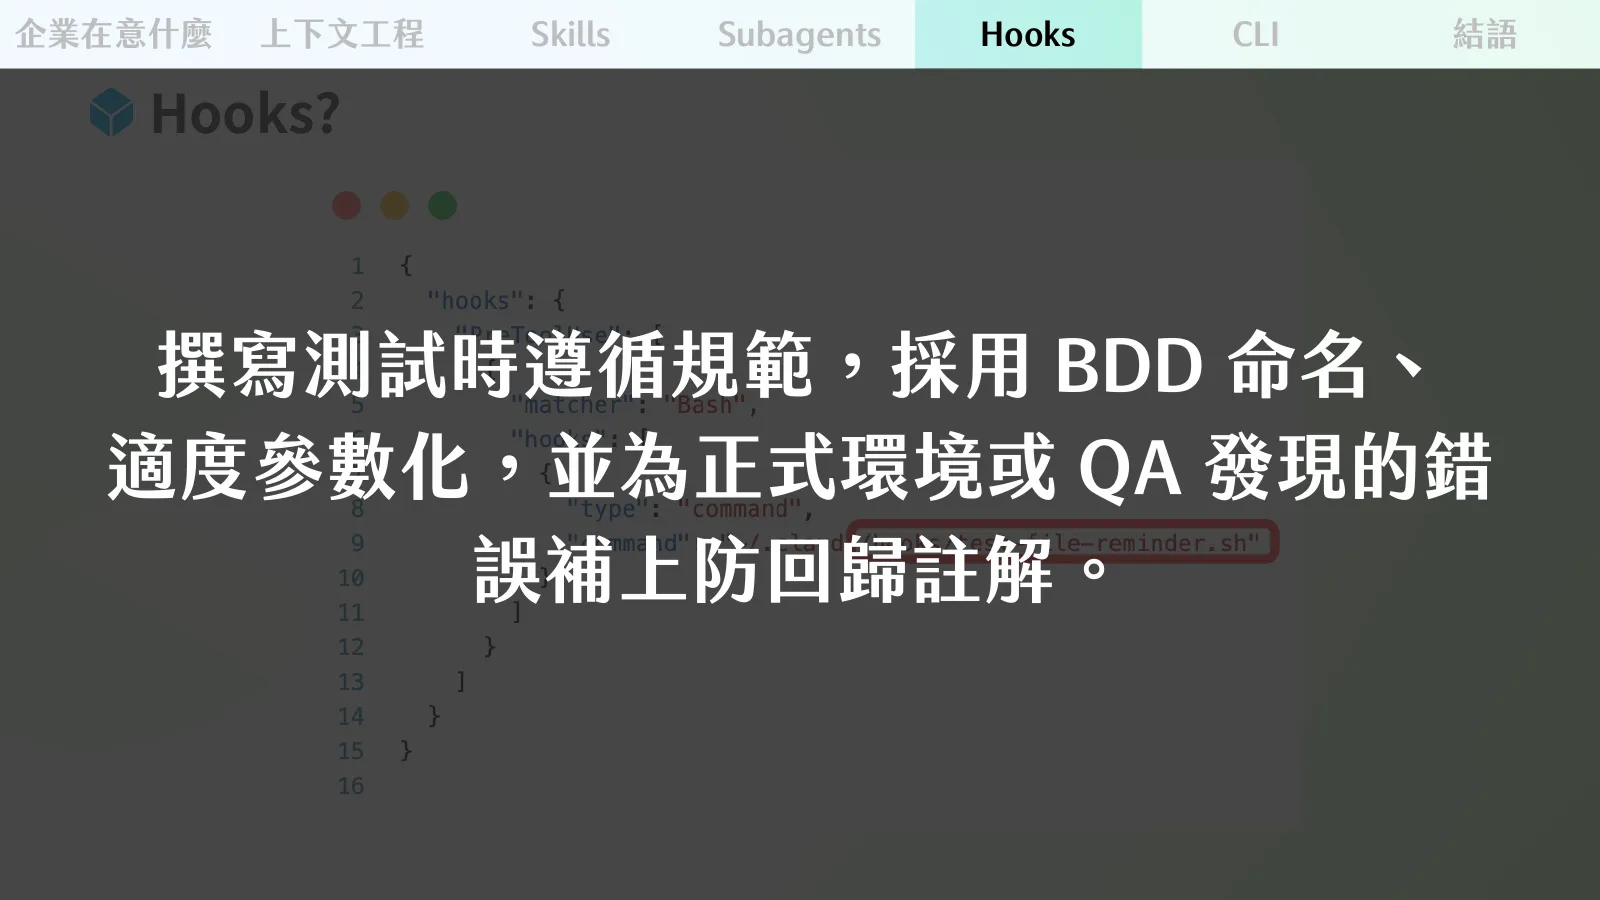
但我有個不一樣的用法是,我有某些自己的習慣,例如測試我喜歡用 BDD 的命名,但我又不相信 Claude 能在寫測試時自己讀 skills,也不想每次要改測試都手動觸發 skills,我希望能讓他在改測試相關檔案的時候,自動提醒我的命名習慣,我會透過 hooks 來自動幫我下 prompt,改測試檔時 Claude 會自己被提醒說,撰寫測試時遵循規範,採用 BDD 命名、適度參數化,並為正式環境或 QA 發現的錯誤補上防回歸註解,這樣我就能跨專案的在正確的時候讓框架自動提醒 Claude 了
小結
機制相關的 Context Engineering 的分享大概到這邊告一段落,小結一下前面的重點:善用 Skills 的漸進式揭露管理上下文、Subagents 處理「只重結果,不在意過程」的任務、Skills 結合 Subagents 能讓給 Subagents 的指令每次都相同、Hooks 的初衷是副作用,讓模型能夠得到機械式的回饋、可以用來在特定場景自動注入 Prompt
接下來分享另一個我做 Context Engineering 的方法,主要是透過我自己開發的 CLI 工具(cc-session reader)來進行
透過自製 CLI tools 做 Context Engineering
我做了一個叫 cc-session-reader 的 CLI 工具,能讓 Coding agent 去讀我跟 Claude Code 的歷史紀錄
一開始其實只是我會每隔一段時間跟 Claude 去復盤過去的記錄有沒有可以優化的地方,比如一直在提醒某件事情,可以抽成 skills,或是一直在叫他不要做什麼,可以抽成 hooks 之類的,但因為 Claude Code 的記錄在本機是一個 JSONL 的格式,我注意到每次他都要自己寫 python 去過濾不必要的雜訊,並且一直在抱怨很多噪音,於是我就想說,與其讓他每次自己寫,不如我幫他做好一個工具
工具的設計邏輯
我的設計邏輯是完整保留 User 及 AI 的對話,壓縮工具細節。保留對話的原因是我相信大部分的資訊量其實都存在於對話,甚至每次 AI 也會在執行完工具時重複結果,比如要找某個檔案,找到時他會自言自語說「找到了!」所以我認為保留脈絡是最重要的
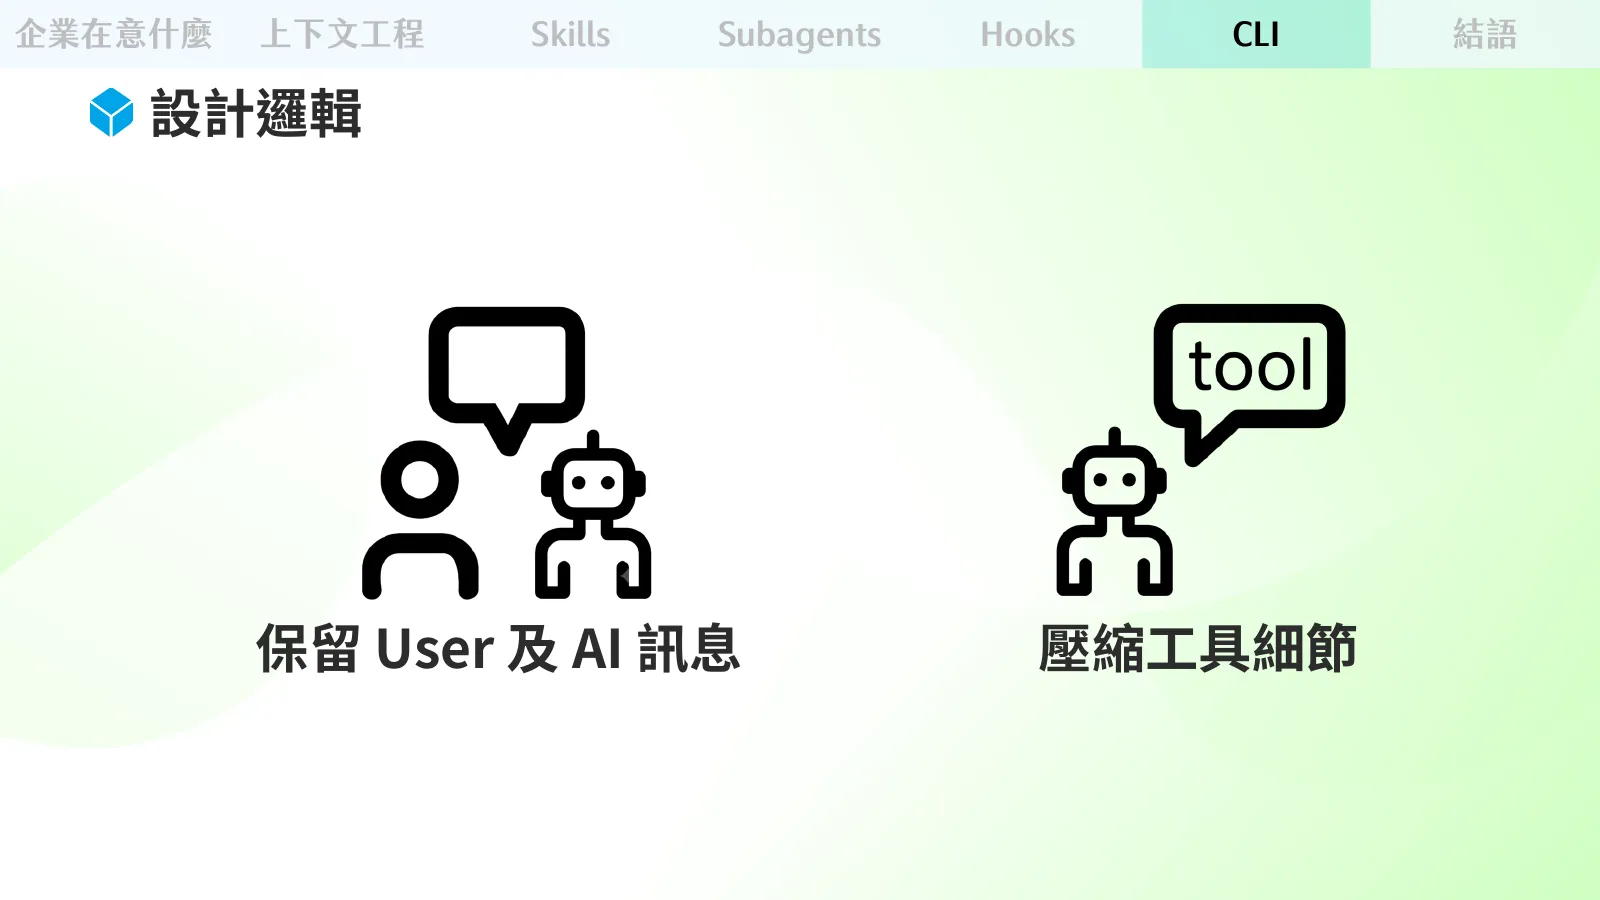
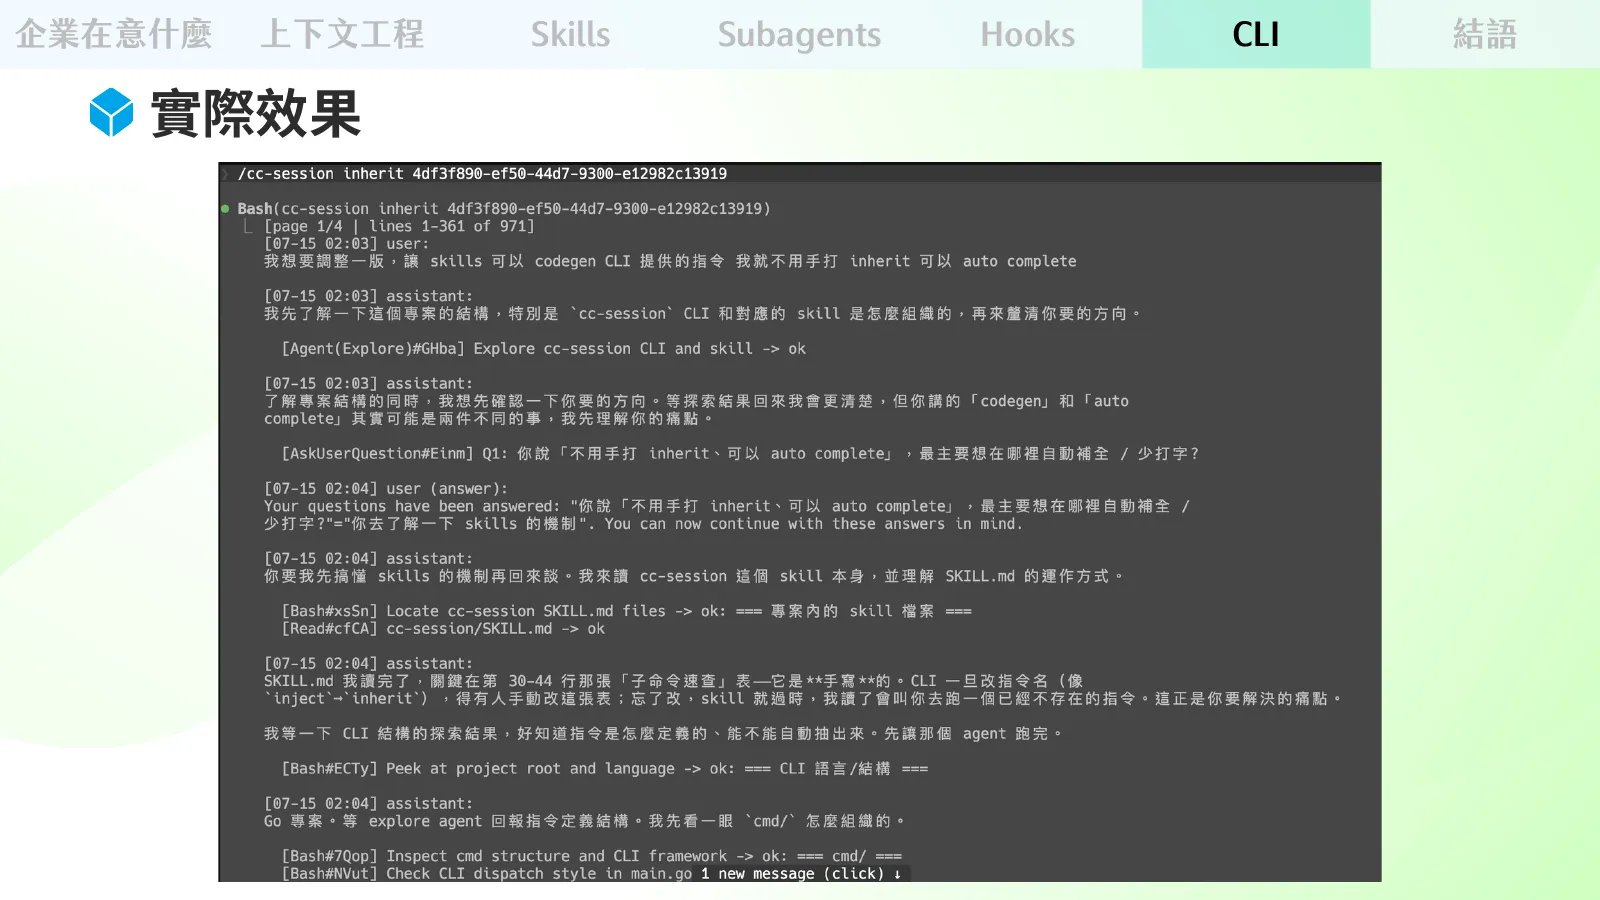
壓縮工具的原因就是因為我覺得工具是可重複執行取得結果的,比如他看過哪個檔案,或是跑了測試,新對話可以再看一次,再跑一次就好,而且其實 Context 很大部分都是來自於呼叫工具讀取檔案,可能有一些探索過程,新對話繼承時就能根據脈絡決定只要讀哪些檔案就能理解
意外發現的用法
講完設計邏輯之後,前面提到我的初衷是去讀過去的對話,找出可以改善的地方,但有一天跟我們公司的 PM 分享,他說會不會這個可以取代 auto compact,因為有壓縮效果,我覺得是個很有趣的議題,於是我就往這個方向去研究了
Auto compact 的原理
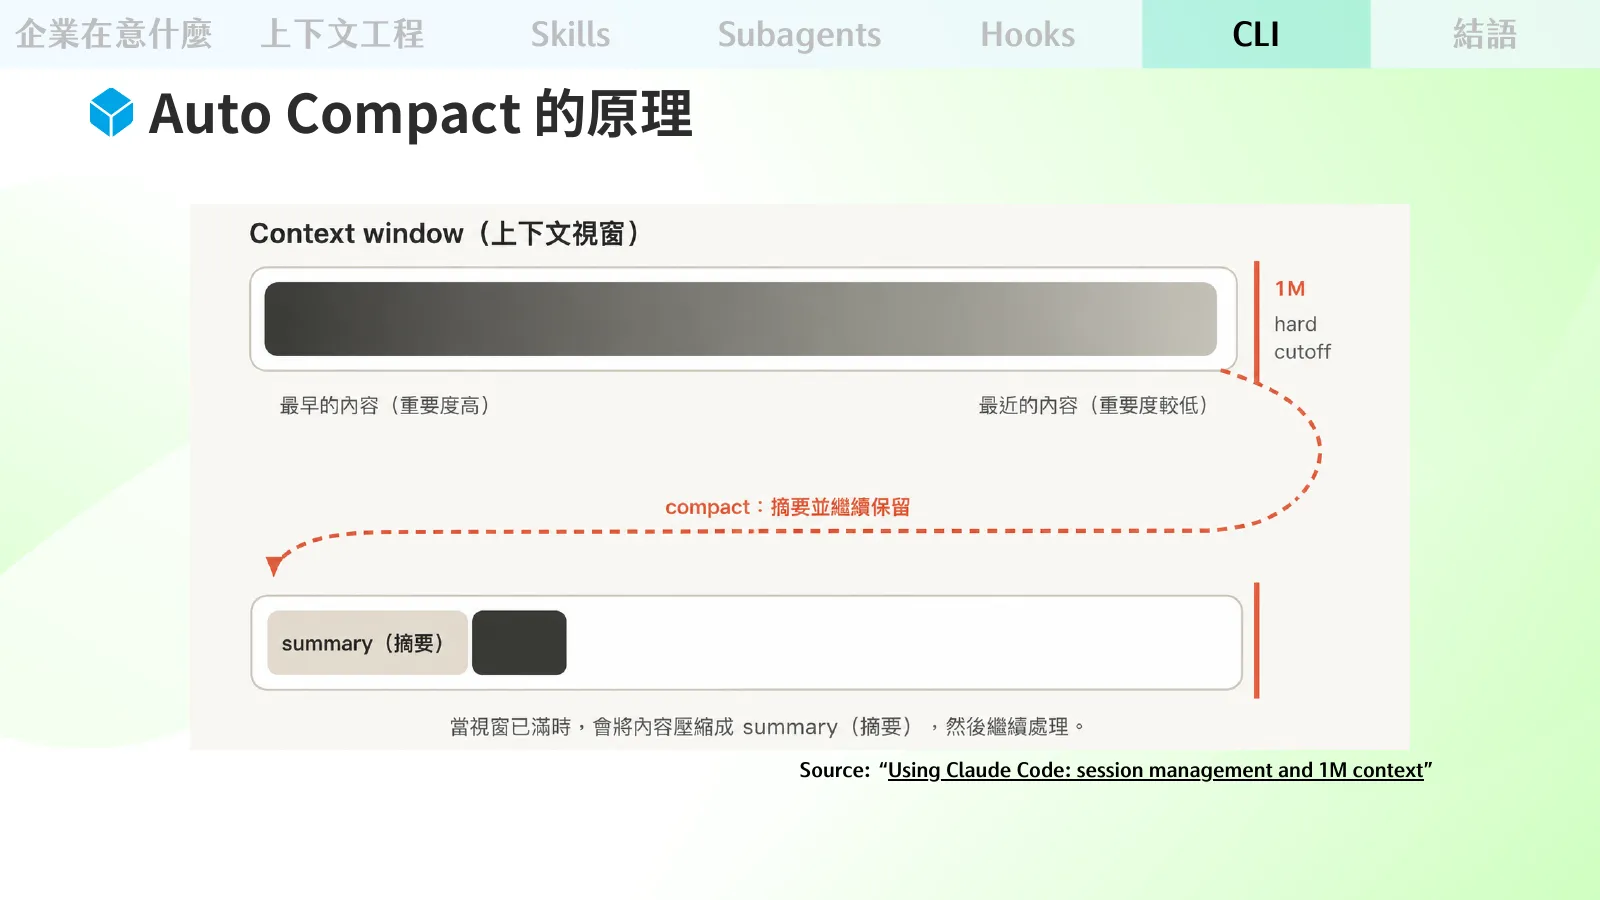
先稍微回顧一下 Auto compact 的原理,承前面的箱子例子,其實就是箱子滿了,然後讓 AI 判斷說箱子裡面哪些是不重要的,去蕪存菁的一個過程,壓縮完之後作為新的 session 的開頭,然後繼續下去。但這個壓縮過程是黑箱的,基本上不太知道會移除掉哪些細節,可能會誤殺重要的內容
證明比 Auto compact 好?
如果要取代 Auto Compact 的話,我認為要嘛要能省到錢;要嘛他效果比 auto compact 好,我願意多付點錢,所以要從比較客觀的方式來做驗證
把我最近跟 Claude 對話 session 的表格攤開來看,截圖中有三欄,Context、NewCtx、Context 省下多少的比例
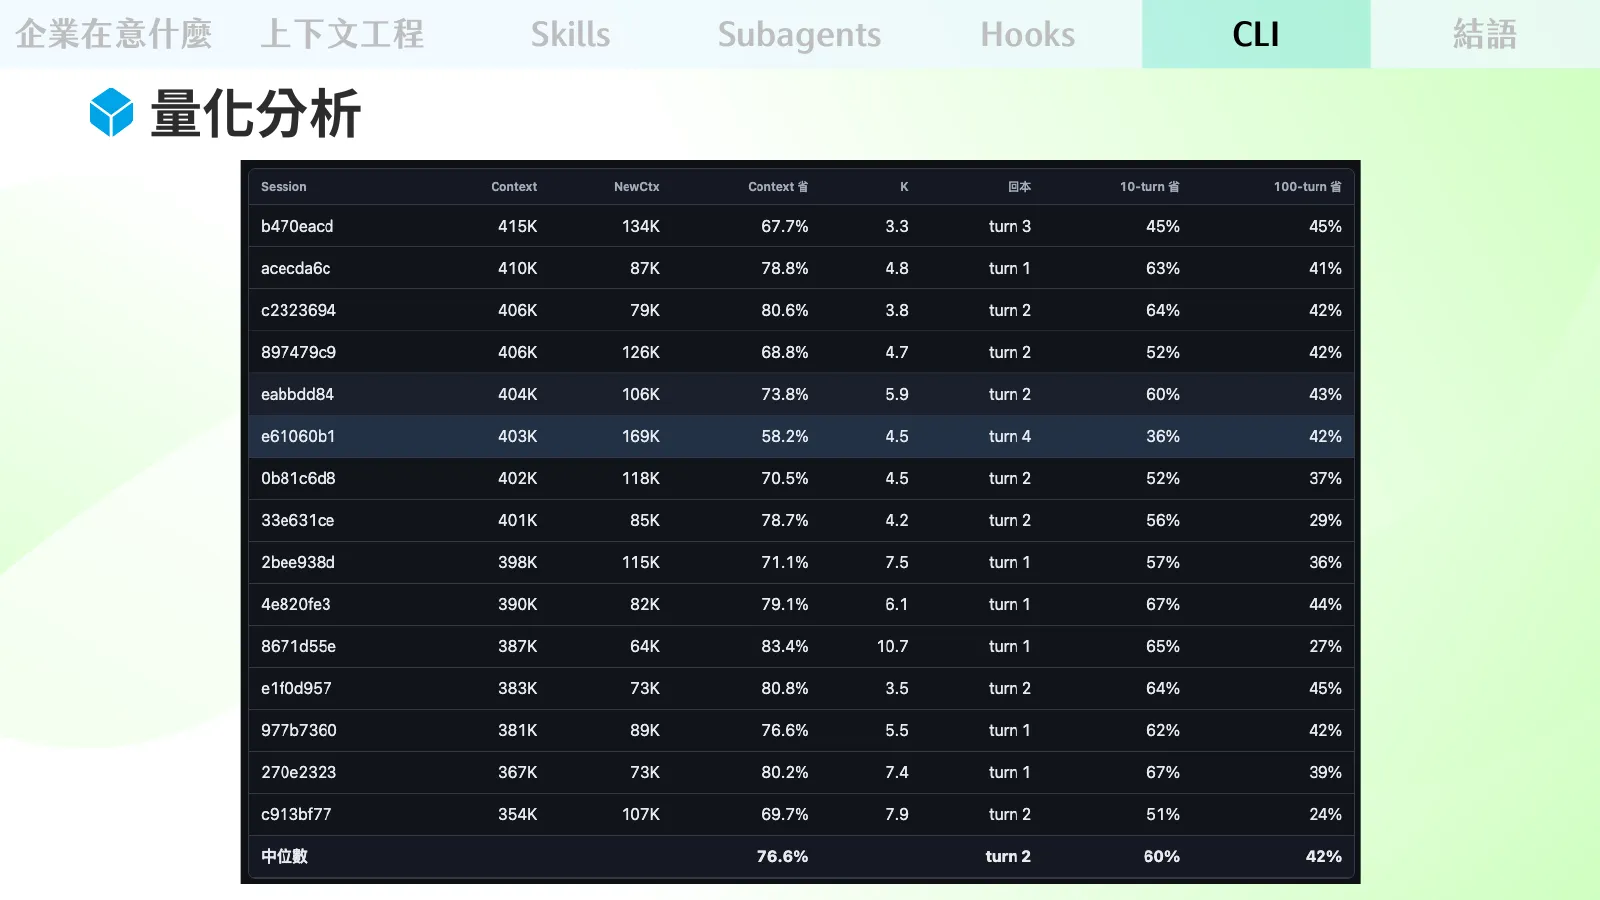
Context 指的是我已經停止使用,可以想成準備要被 auto compact 的了,NewCtx 是使用我的 cc-session reader 之後佔用的 context,Context 省下多少的比例就是新的跟舊的比起來省下多少百分比的 Context, 大概平均是 7 80,中位數是 76.6
再來是看在新對話中,跟舊對話比是不是真的會回本省錢,有兩欄,一欄是 K,一欄是在新的對話中,第幾輪開始會省錢,這邊的重點在於這個 K,定義是「每次下 prompt 模型呼叫工具的平均次數」,因為前面提到,我的設計邏輯是把工具的結果壓掉,因此理論上 K 越大,壓縮效果越好,也就越省錢
實際細看一個 session 使用工具的金額
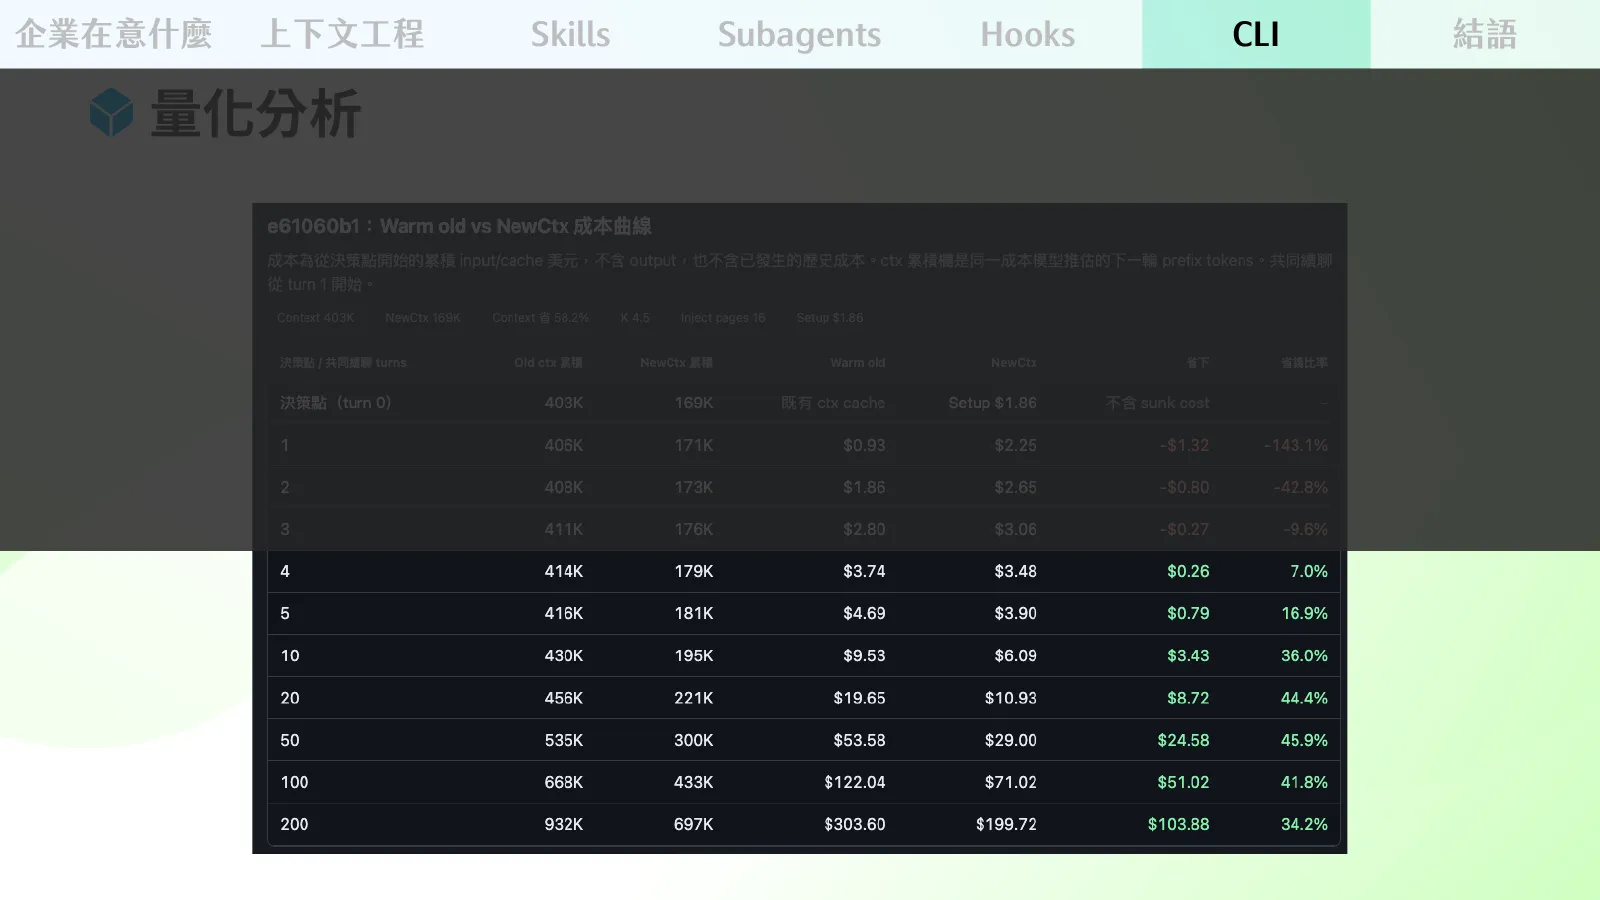
我挑出其中一個 session 來看,對比原對話跟使用工具的新對話,兩者的成本差異,這邊的成本是用 Anthropic 官方的 count token 算出來的。在新對話裡面,使用 cc-session reader 一開始是賠錢的,因為舊的對話有 cache 的紅利
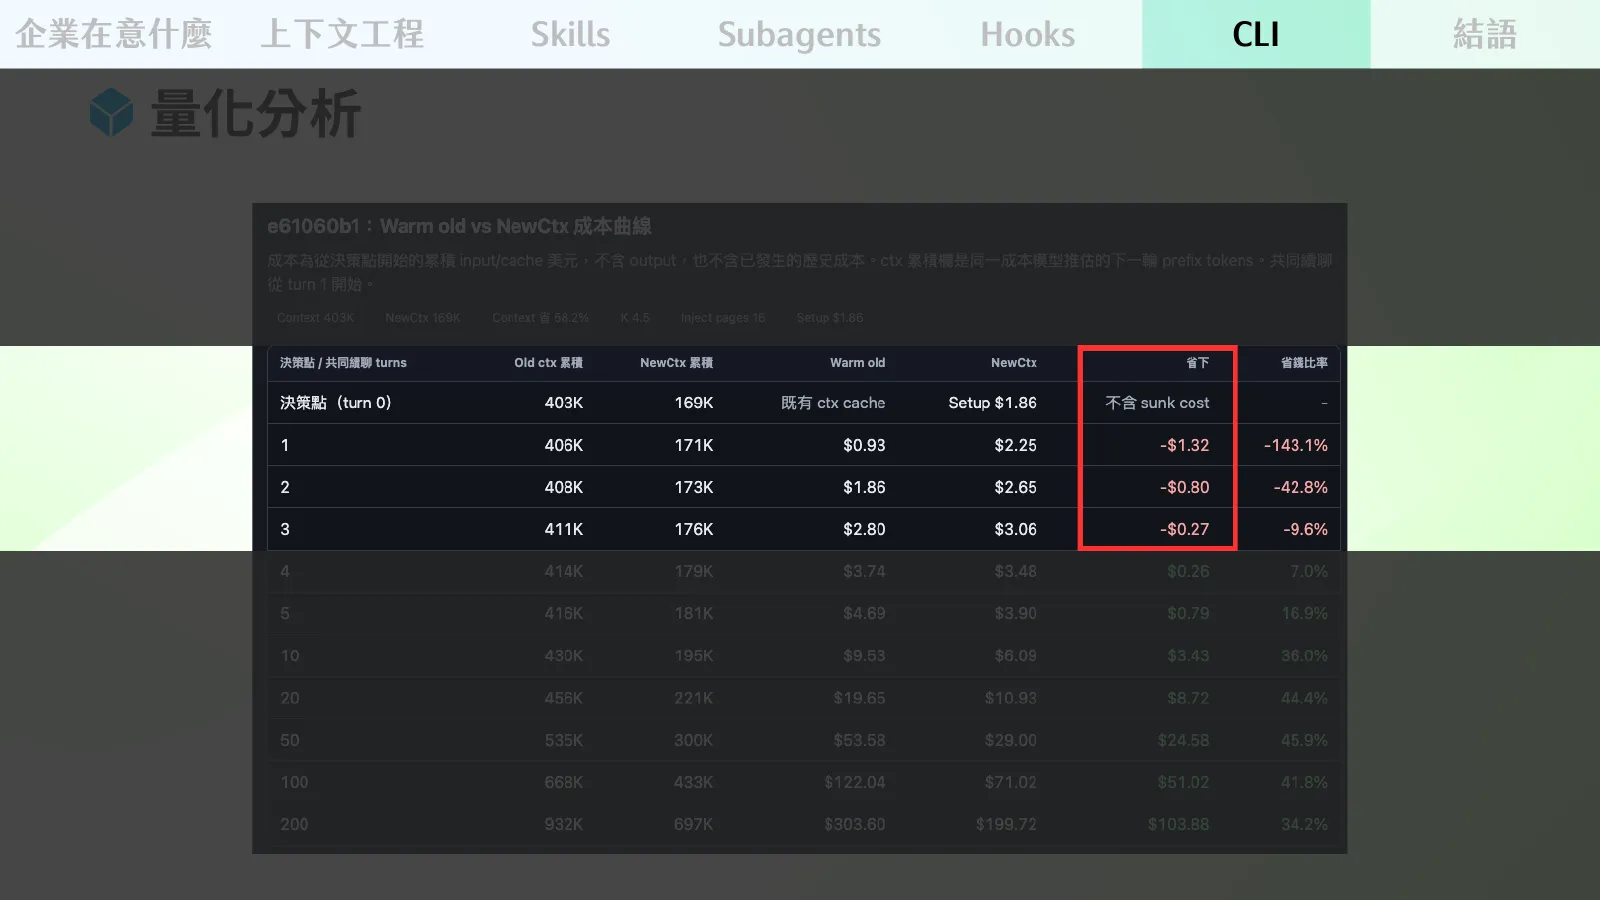
但可以注意到賠的錢越來越少,因為新對話的總體 Context 比較少,而且第二輪開始也有 cache 紅利,一直到第四輪就超車原對話,然後一路省錢下去
總結
雖然 AI 時代各種名詞推陳出新,但本質是怎麼讓模型有更好的輸入,以獲得更好的輸出,今天的分享希望能帶給大家的是善用 Skills, Subagents, Hooks 等機制來達到上下文管理