很開心昨天能在 Hello World Dev Conference 分享初級工程師如何 AI 賦能的翻寫一個跟自己年紀差不多大的框架,認識了很多前輩,也聽了很多精彩的分享,能跟其他講師一起同台分享實屬榮幸😆
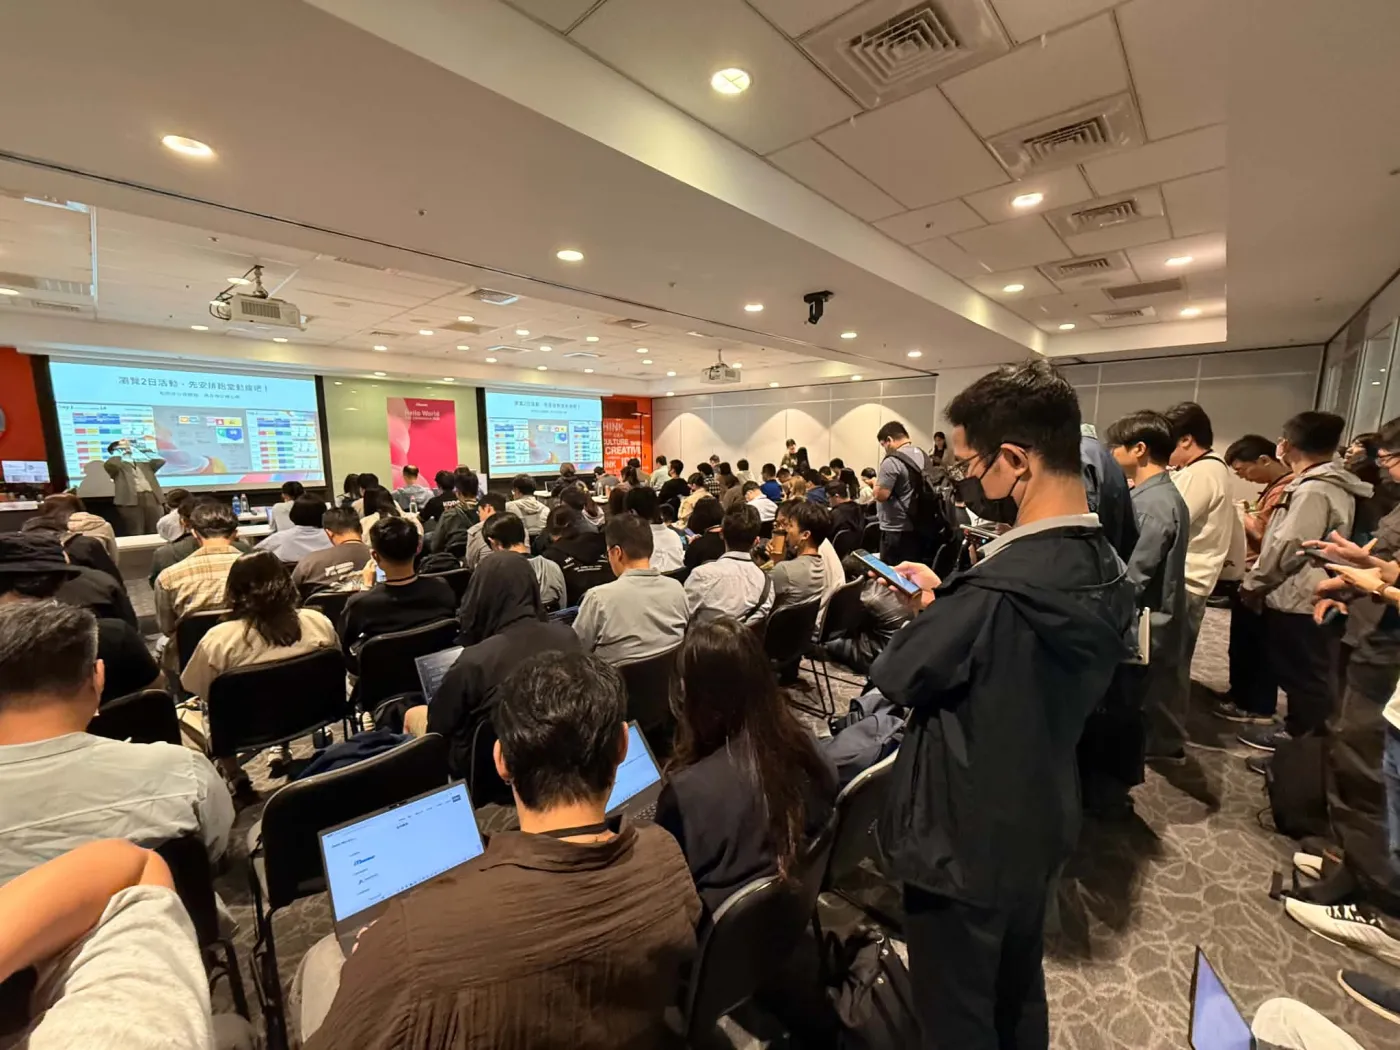
來聽分享的聽眾有一點點多,受寵若驚😅謝謝昨天願意來聽我分享的朋友,希望昨天的分享有讓大家學到東西,沒有辜負大家的期待!
這篇把當天的講稿整理出來,也把簡報分享給大家
為什麼要翻寫一個跟我年紀差不多的框架
先簡單自我介紹一下,我今年 23 歲,畢業於政大英文系,二月退伍後四月開始第一份工作,現在是網站開發工程師,我大部分的技術都是跟 AI 學的
去年也有來 Hello World 演講,同時今年也以自己的身分有接一些演講,還有我也是臉書社團 Claude Taiwan 的社團管理員
在開始談我接手的框架之前,先來個前情提要,就是為什麼我要翻寫一個跟我年紀差不多的框架呢?
故事是這樣子的,我今年四月入職,在入職之前老闆就有說想給我一個棘手的題目,想看我能用 AI 做到什麼程度
當時其實也對棘手沒有概念,然後有說會有其他工程師跟我一起做,應該沒什麼吧
那棘手到底是多棘手?以及跟我年紀差不多大的框架嘛,這個差不多年紀的框架到底是年紀多大?
所以跟大家分享一下我接到的系統架構。我接到的舊系統的框架是用 Java EE,底層走的是負責畫面的 Vaadin,加上負責後端邏輯的 EJB 架構,然後我們要把它翻寫成 Angular + .NET 的前後端分離
翻寫的背景是甲方因為替換了廠商,但這個系統歷史已久,歷史進程中有些 code 消失了,只有一部分有保留下來,然後今年廠商由我們來承接,希望可以對系統做現代化
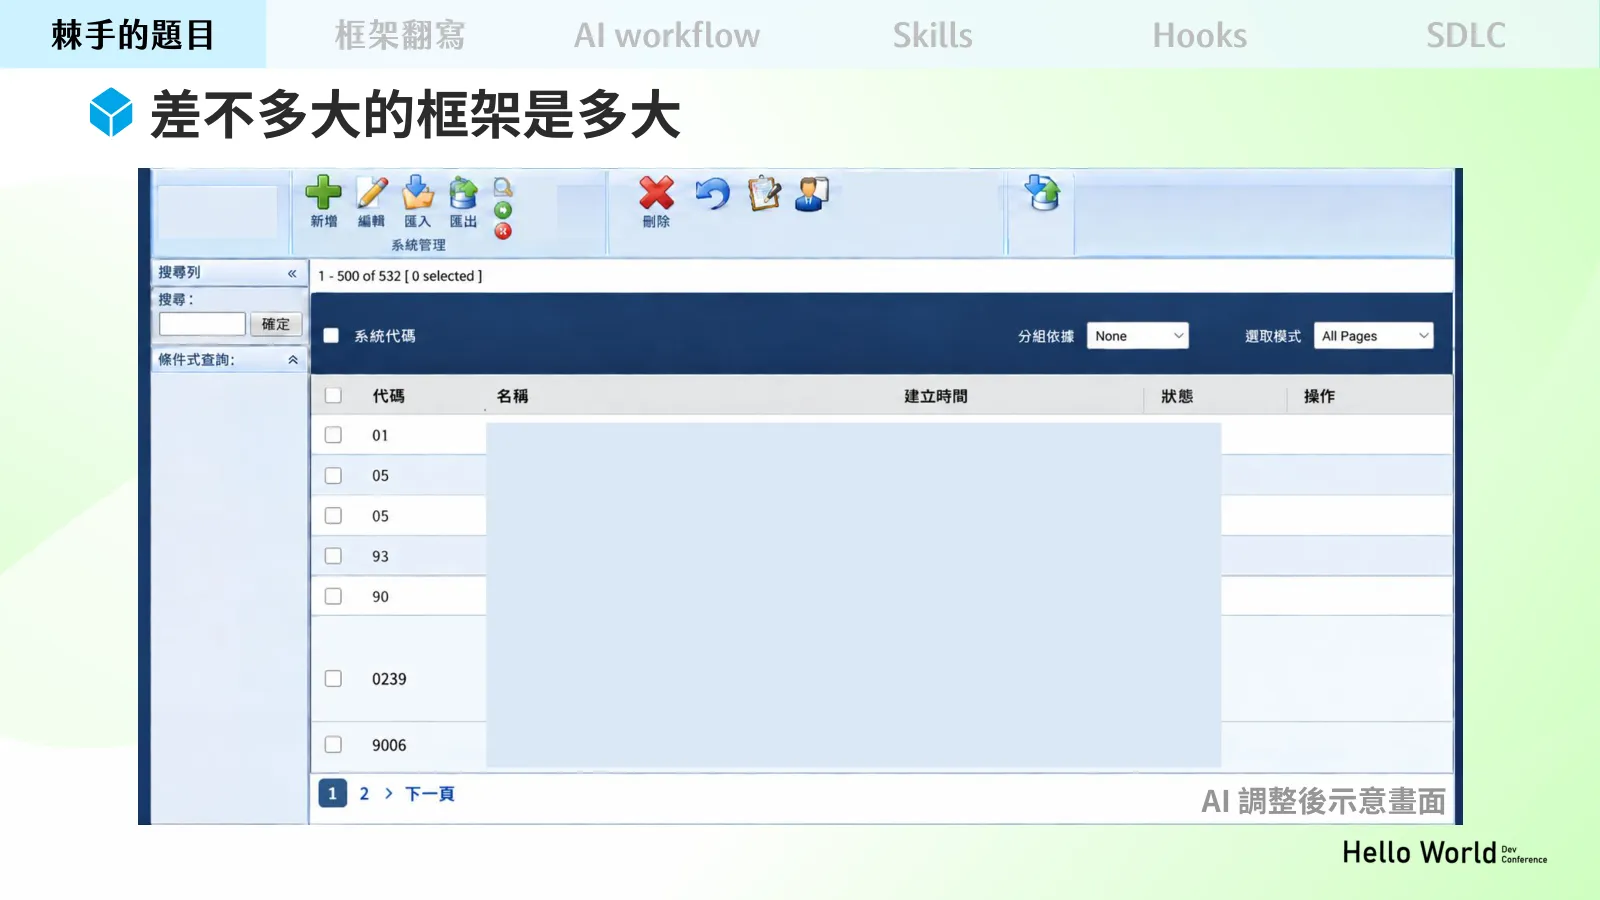
除了名詞之外,也讓大家看一下畫面,我想會更有感覺,應該可以看出來非常的具年代感。像這個 ribbon 的設計大家應該很有感覺,一看就知道非常有年代感,還有這個藍色,以及立體的 icon 的設計等等的
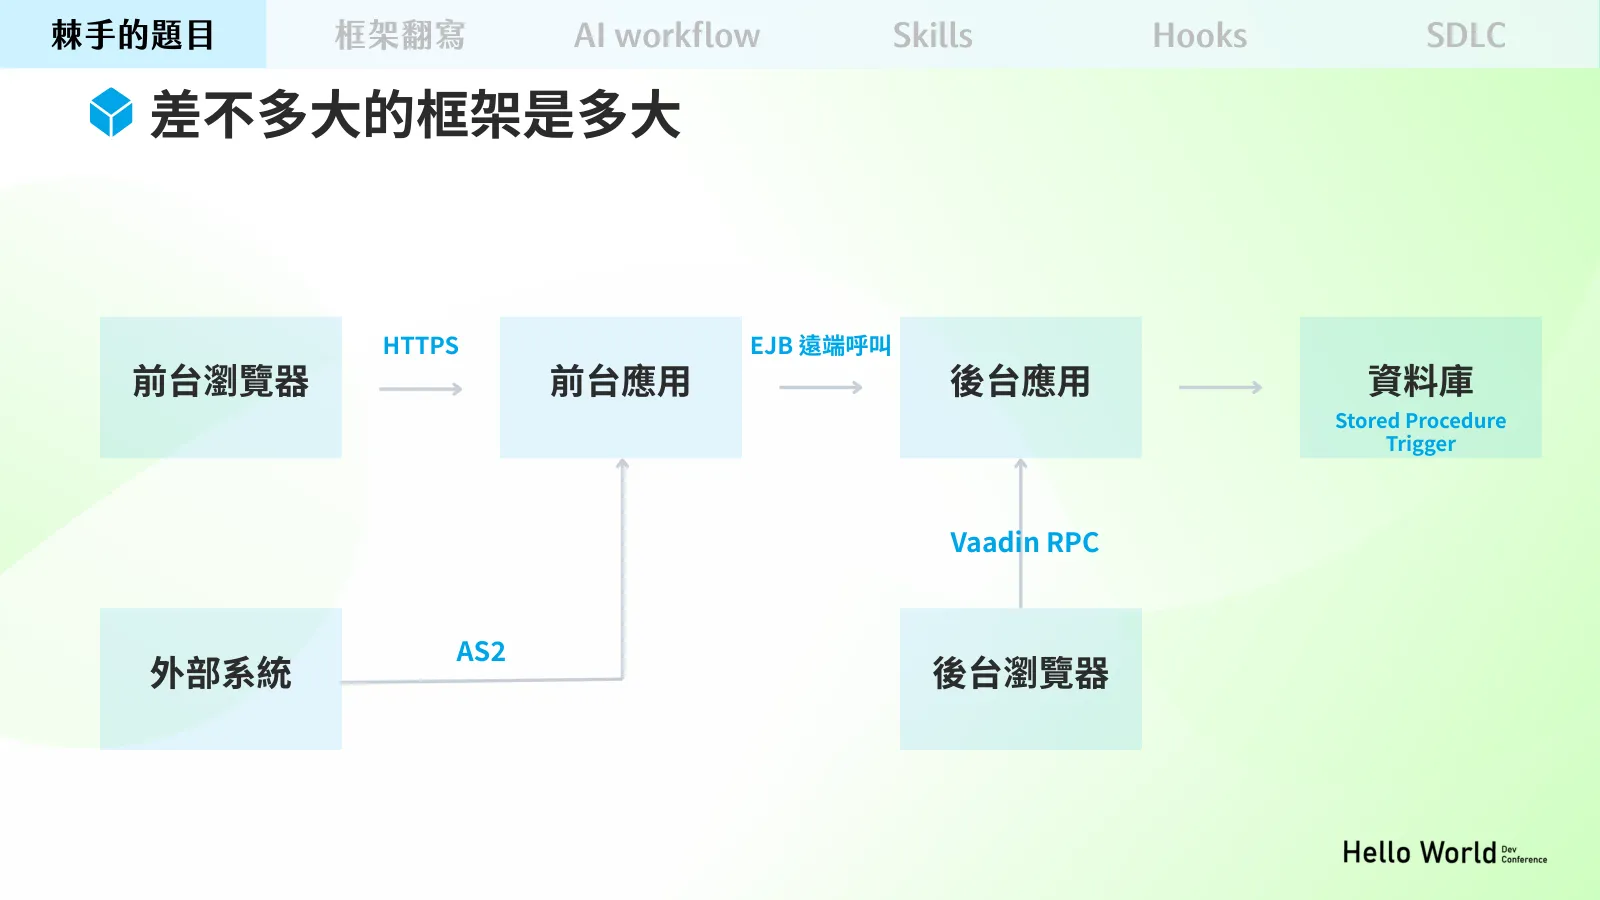
整個系統的架構大概長這樣,有分前後台。比較特別的地方是,前台後端還有接收外部系統透過 AS2 傳遞的資料,然後前後台的後端之間透過 remote EJB 溝通,同時後台也有自己的操作介面。除此之外,還有一部分邏輯仰賴 DB 的 SPs,加上幾百條的 trigger
所以我想,要翻寫這個系統,應該也真的是個不小的挑戰
所以今天的故事就是,我一個 23 歲、英文系畢業,而且第一份正職工作,技術大部分都全跟 AI 學,要把這個,變成這個
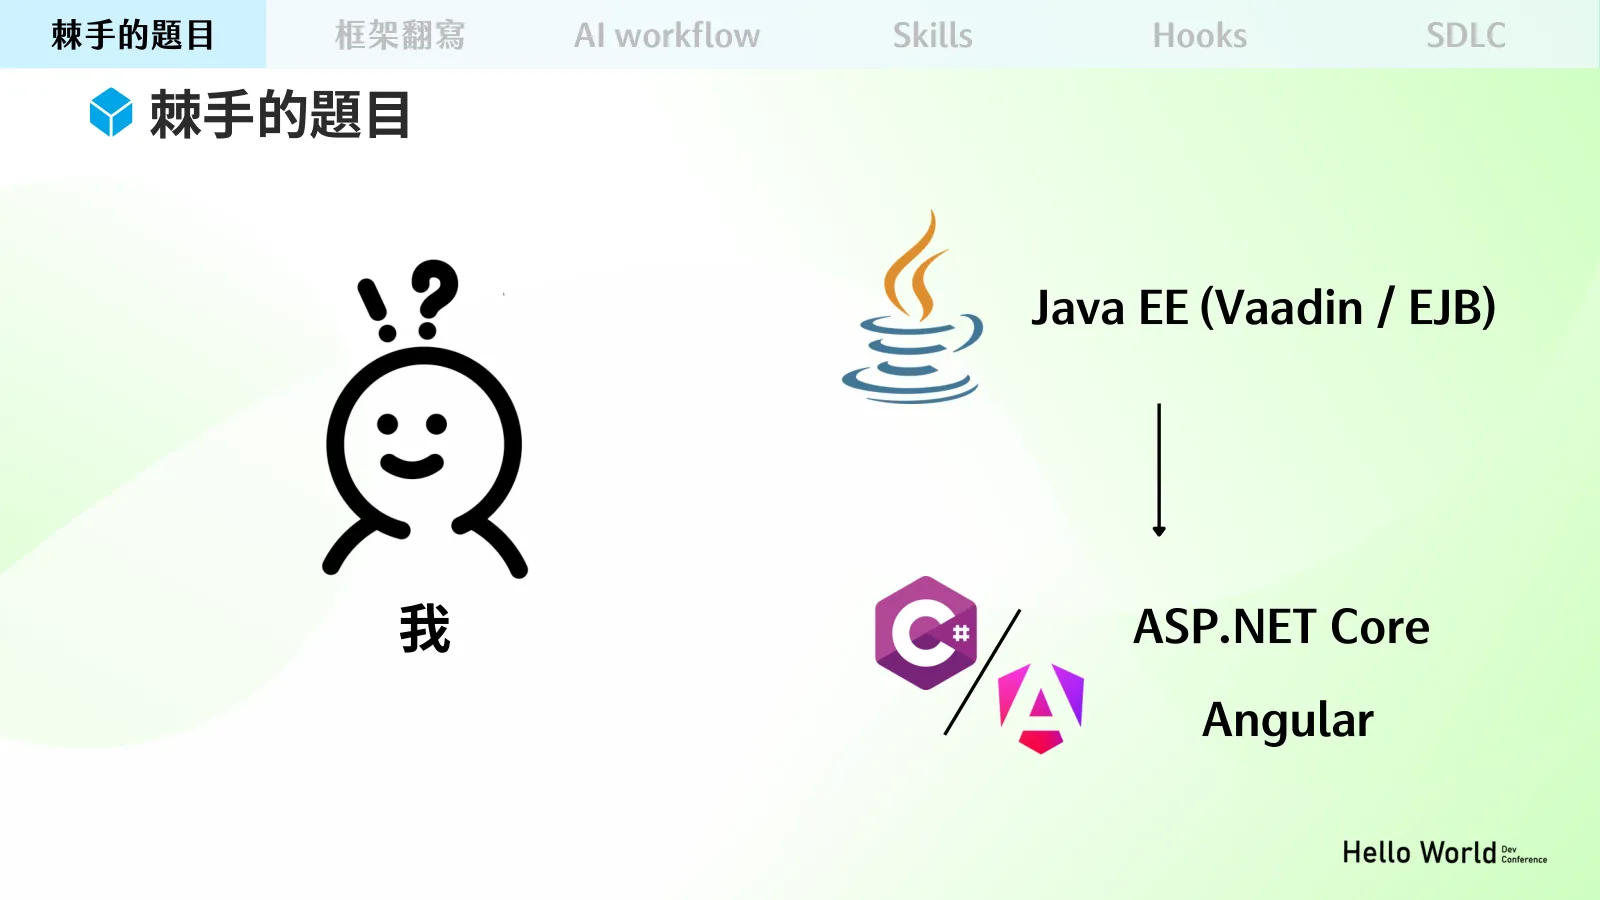
在翻寫這個系統的過程中,我覺得最核心的困難,無庸置疑肯定是系統老舊。除此之外還有就是我們只有得到部分原始碼,所以不光系統老舊、架構複雜之外,又往上增加了一個難度
啊還有 domain knowhow 非常的深,其中一個 feature 需要 200 多條的規則解析
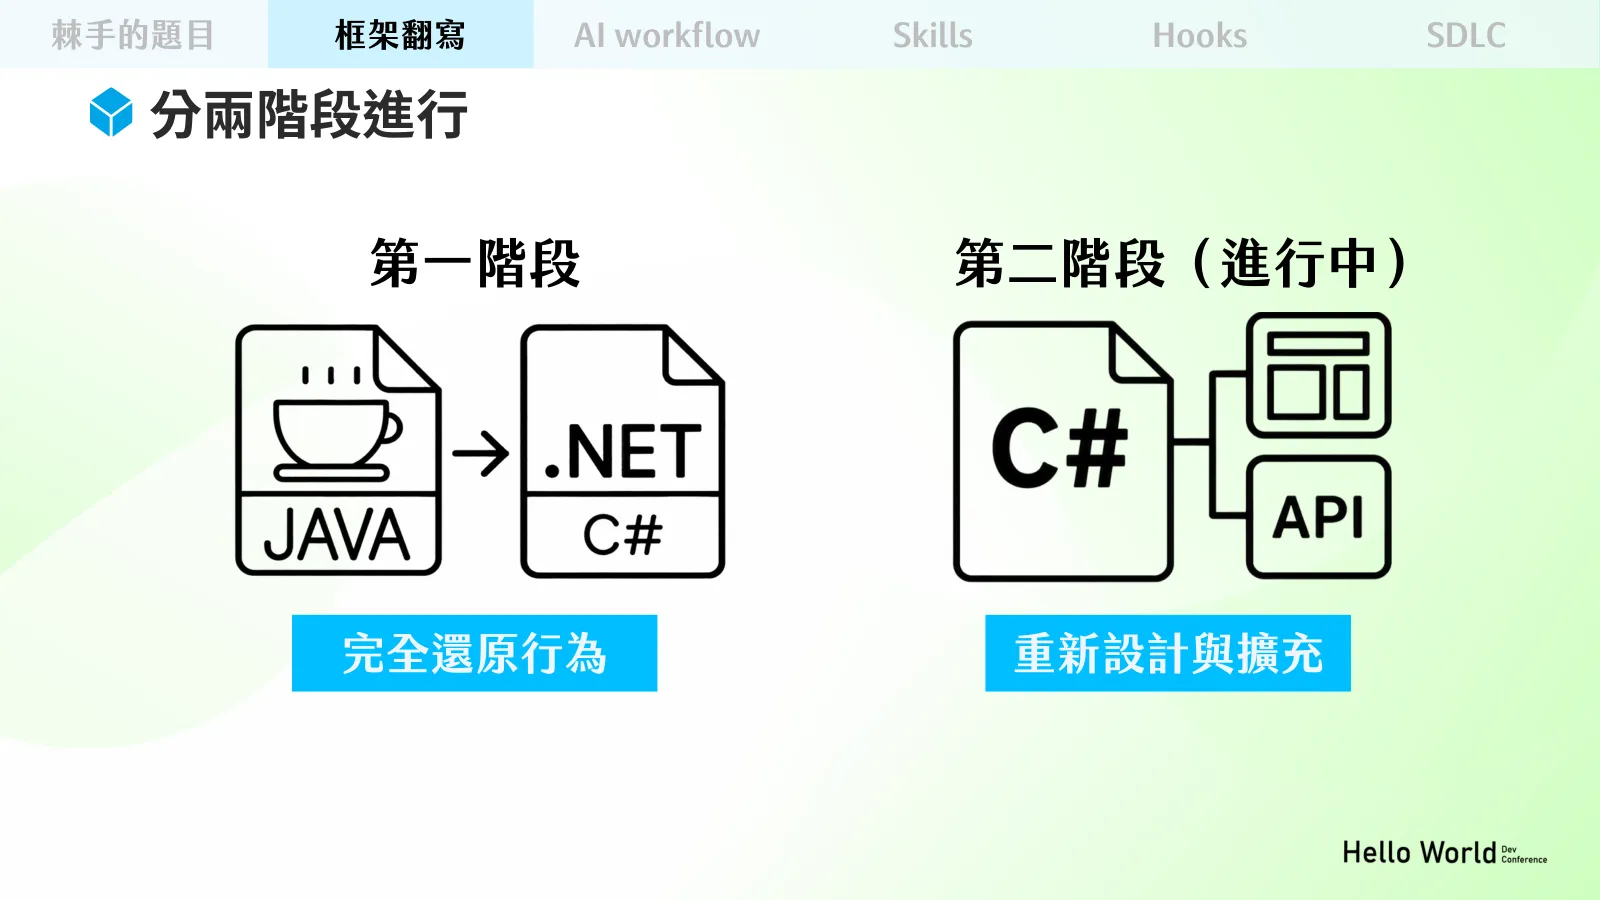
那這個棘手的任務,我們團隊是拆成兩階段進行:第一階段是完全還原行為;第二階段是重新設計畫面及架構,以及擴充系統能力。主要內容會放在第一階段,也會分享第二階段目前有碰過什麼樣的困難
第一階段:完全還原行為
第一階段的目標,是把黑盒子的系統變成有原始碼,並且在翻寫的過程中逐步理解這個系統。這一階段唯一的精神是我絕對不動資料庫,唯一的要求是新翻出來的東西,行為要跟舊系統一致
沒有原始碼也沒有測試,我要怎麼知道行為與原系統一致?其實就是把寫出來的 code 寫測試去驗證,然後觀察 DB 的狀態有沒有相同
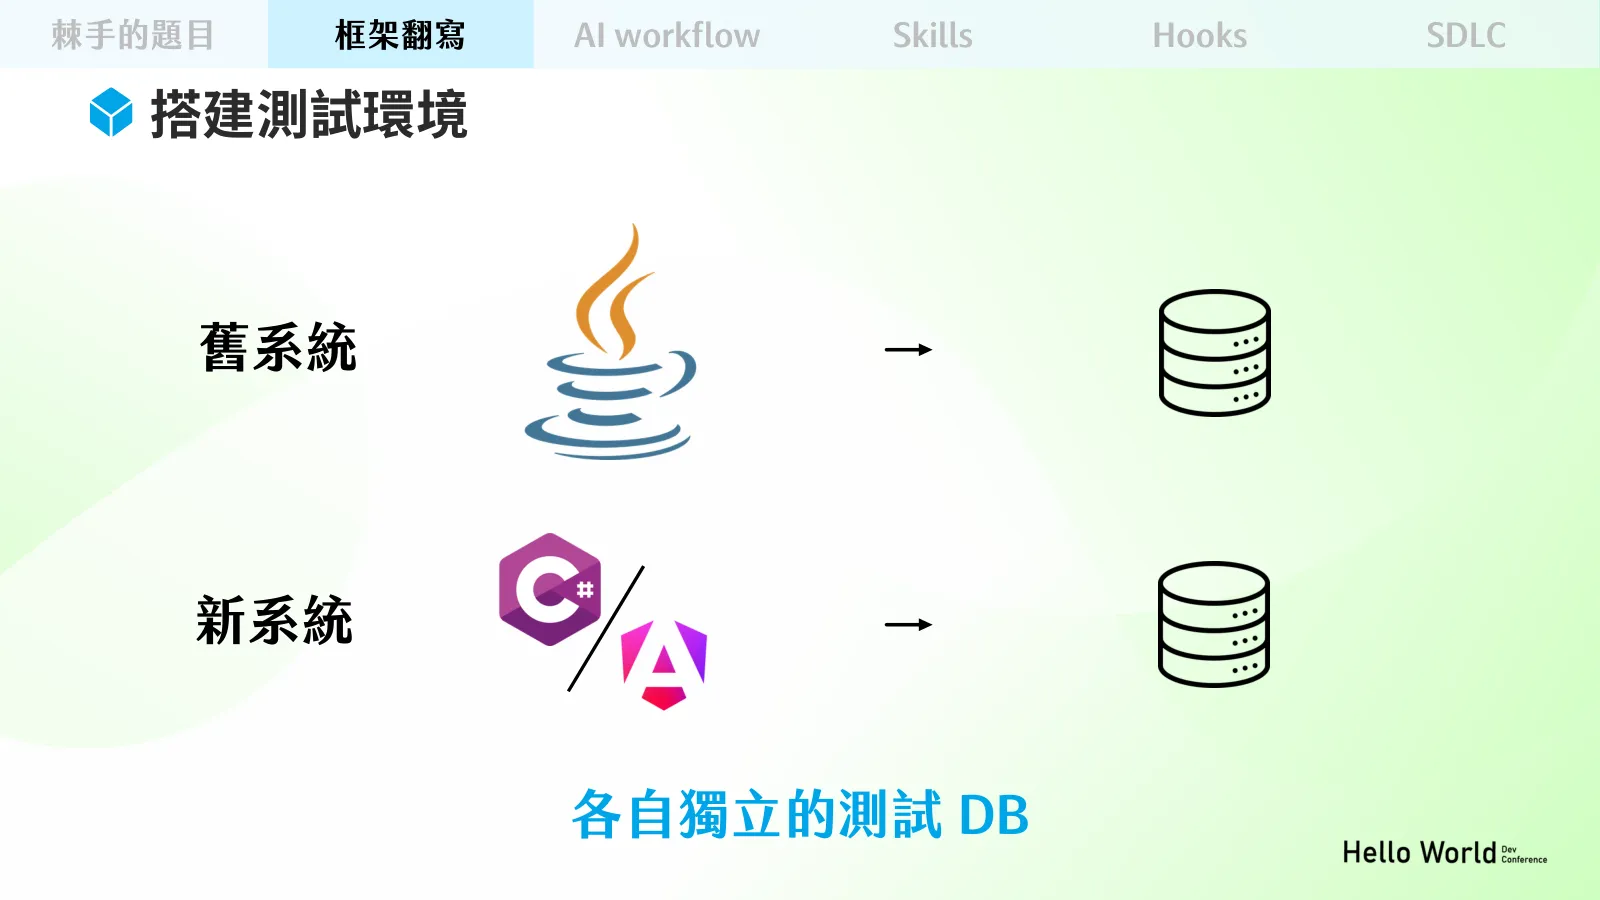
因為我沒有原始碼,所以要知道舊系統的行為,就只能把環境架起來當黑盒子去敲,觀察操作前、操作後的 DB 狀態,然後新寫出來的系統做同樣的操作,對比兩邊 DB 的狀態
測試的部分我大概可以分成三個層級:對規格、對邏輯、對結果
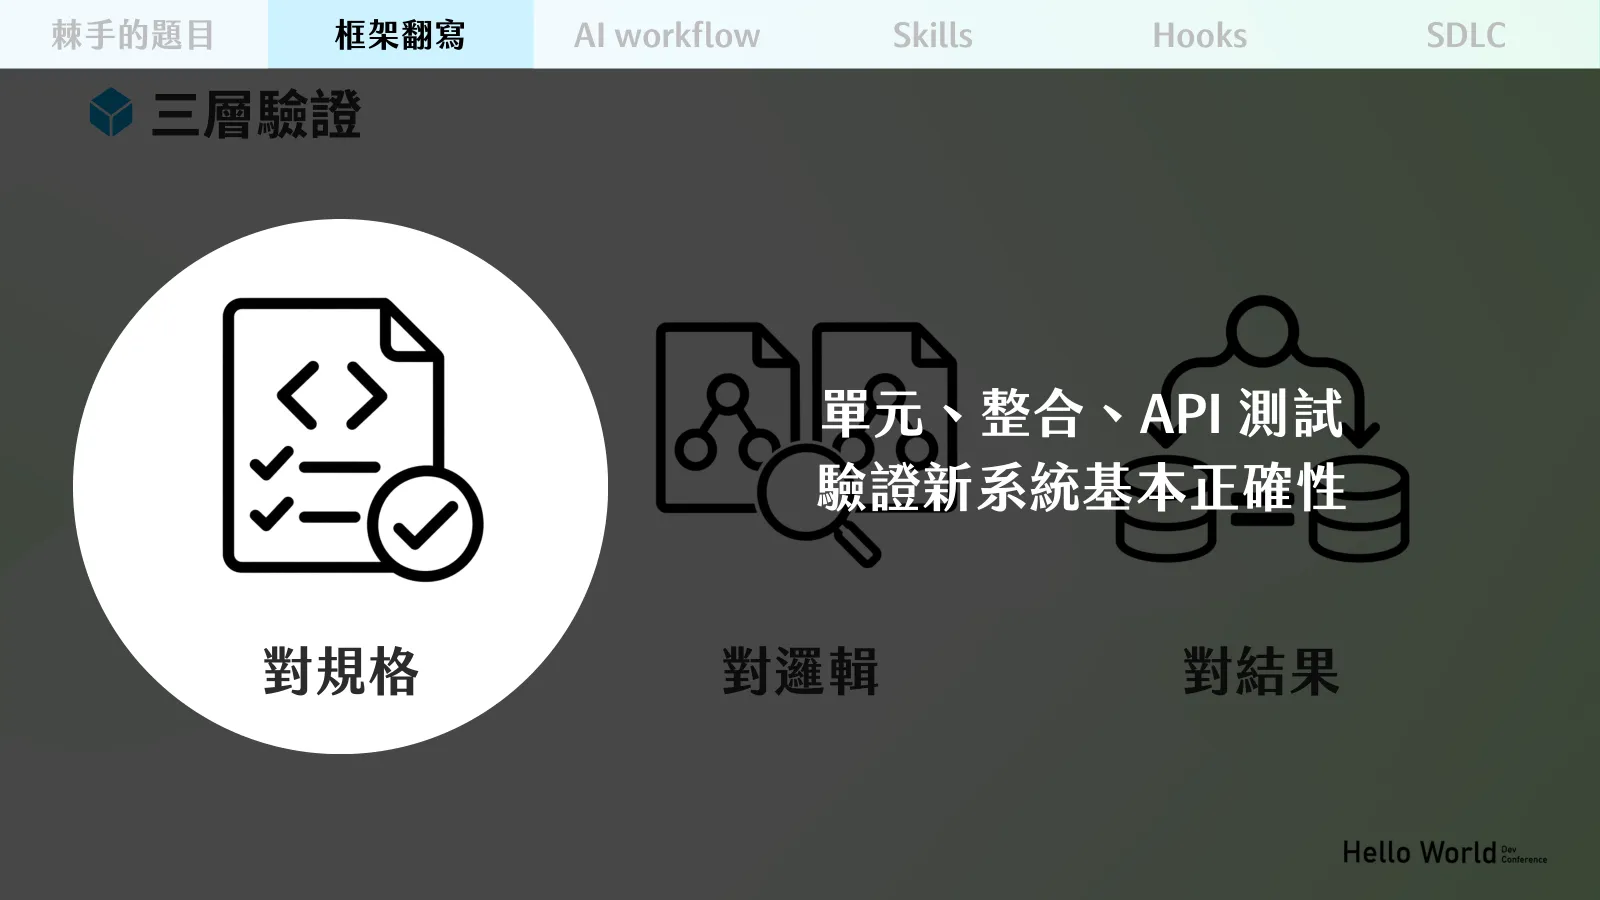
首先,對規格的意思是新系統自己的各種測試,至少先驗證新系統沒有低級的錯誤、是能運作的,後面才能跟舊系統對比
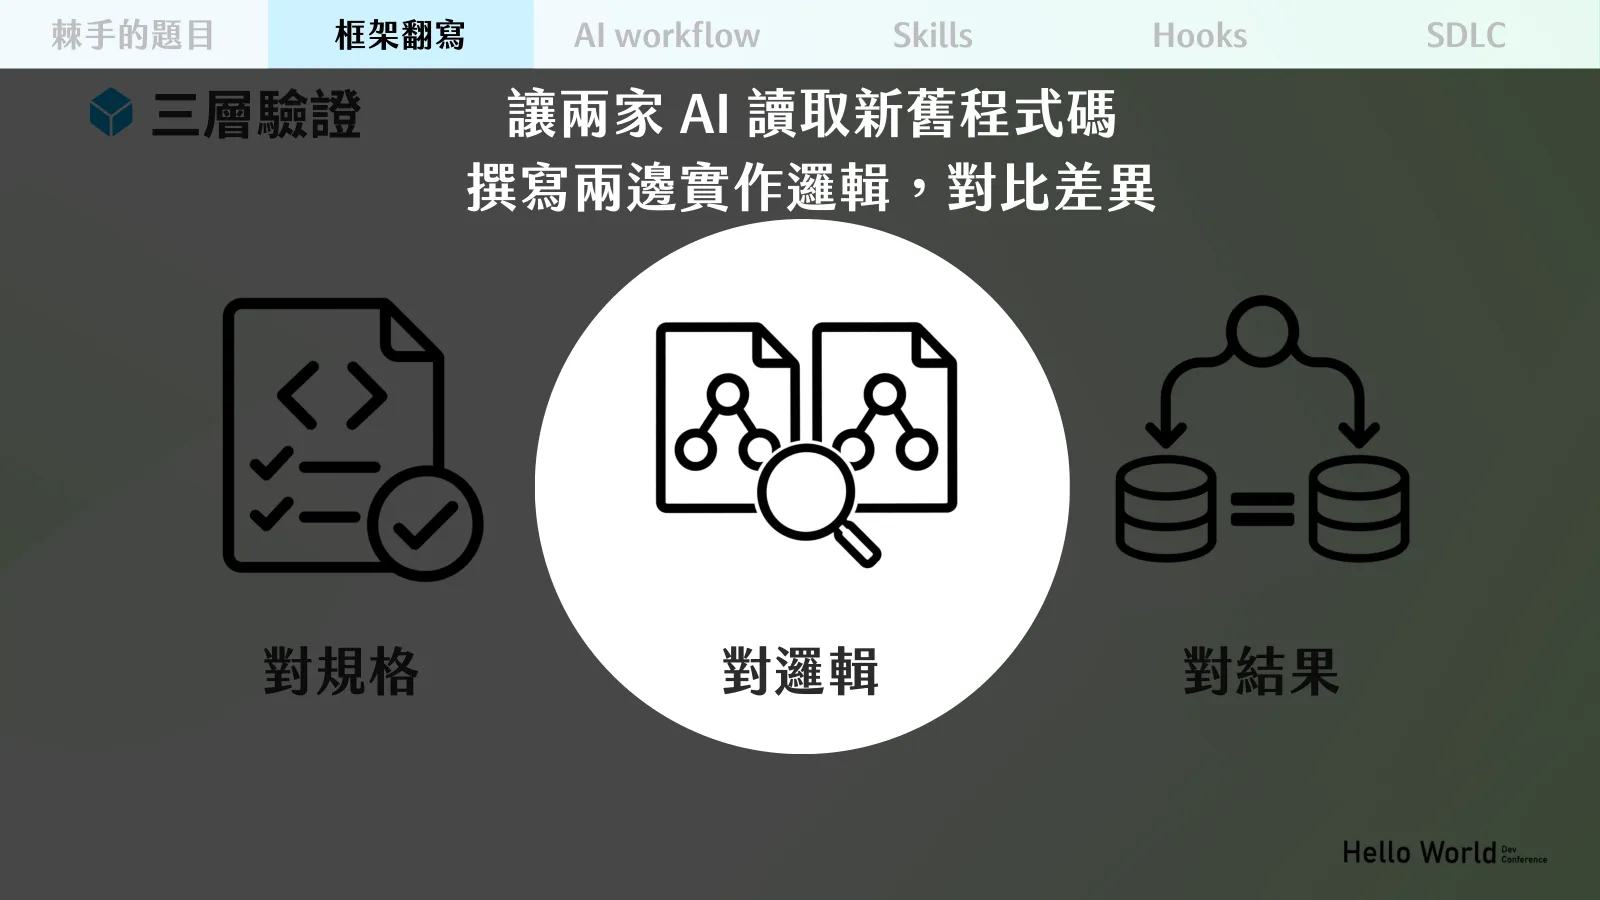
再來是對邏輯,我是用兩個不同家的 AI(Claude Code 跟 Codex)去看新系統的實作,以及舊系統的實作。有源碼的部分看源碼,沒源碼就看 log、正式機的資料或文件去通靈。看兩邊寫出來的文件有沒有差異,如果 1:1 翻寫正確,邏輯上應該是要相同的
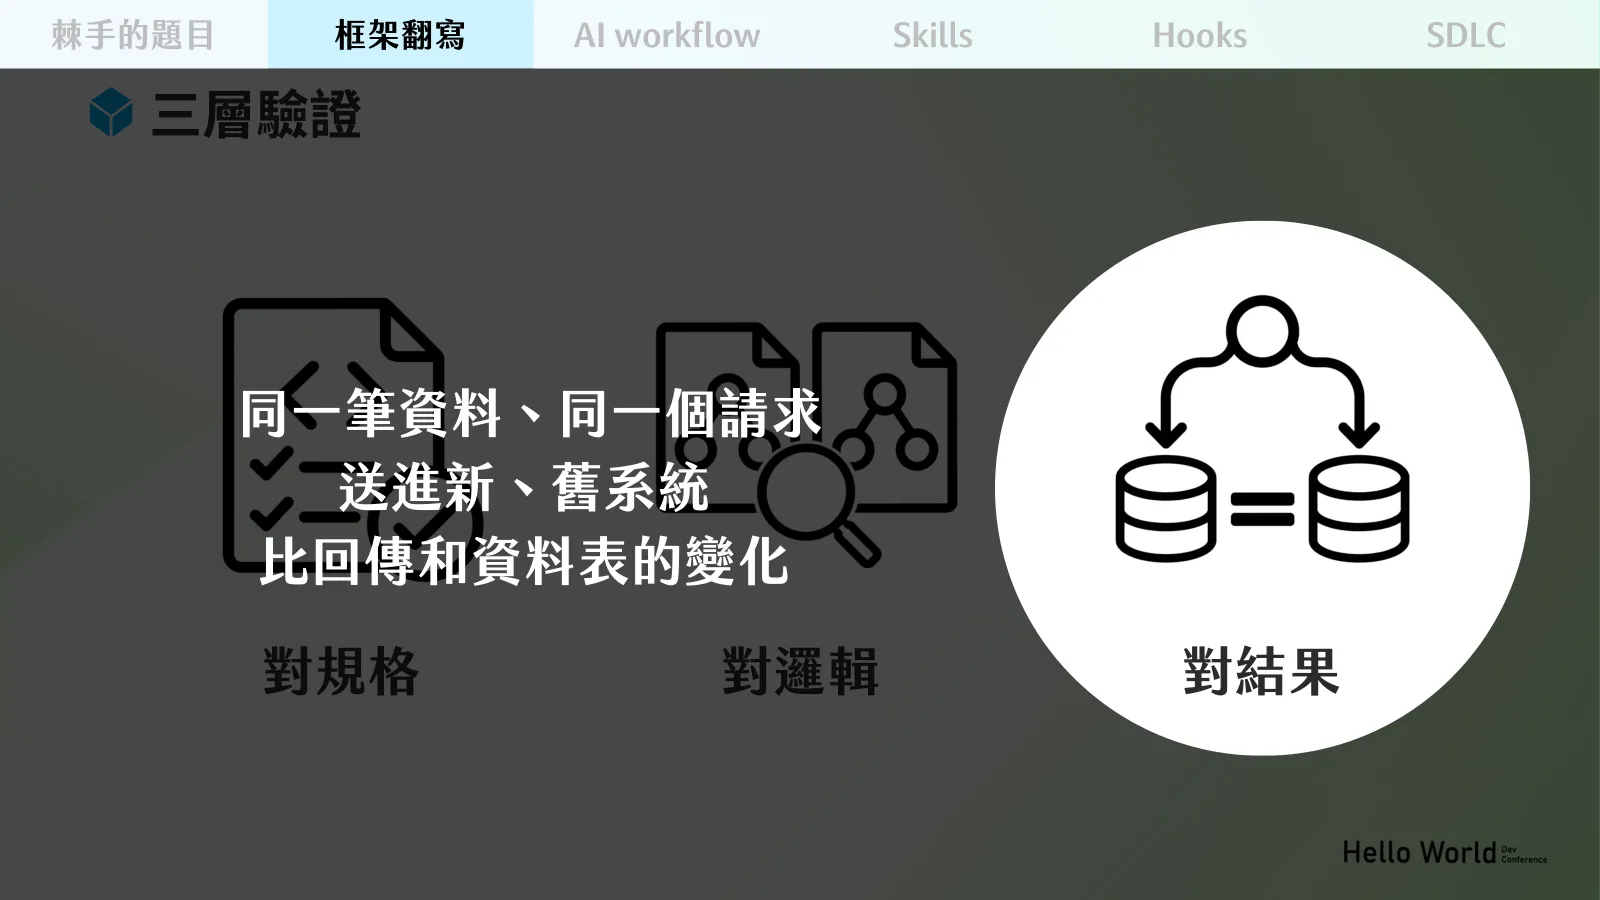
最後就是對結果,觀察舊系統前端送什麼 request、得到什麼 response,新系統用同樣的 request 送進去,要得到同樣的 response,並且兩邊寫的表、欄位、資料內容要一致。這邊就不是用 AI 看,而是用寫好的對比腳本去跑
第二階段:重新設計(進行中)
前面講的是第一階段的整個過程跟驗證方法。第二階段雖然還沒完成,不過在過程中也有碰到一些困難,像是第一階段因為是 1:1 翻寫,一定有非常多的 workaround 以及 code smell,這些 legacy code 都會影響 AI 在這個階段的產出品質
再來,當要重新設計跟擴充功能時,很多在畫面上「理論上必填、一定會有值」的欄位,實際撈出來卻是有些有值、有些又是 NULL。因為系統轉手過太多次,不知道這到底是前幾手廠商在移轉資料時弄丟了?還是它其實是個早就廢棄的 Legacy 欄位,只是當年沒把舊資料洗掉?甚至還是其他某個功能有寫入,只是我不知道
我的做法是先看這些 NULL 資料是不是都很久以前的,再對照目前已知的測試,看有沒有功能會寫入或讀取這個欄位。資料都很舊、也沒有功能在用的,就推測它是已經廢棄的舊欄位
第一個問題,還有前面第一階段的驗證,我都是靠接下來這套 workflow 處理的
我的 AI workflow
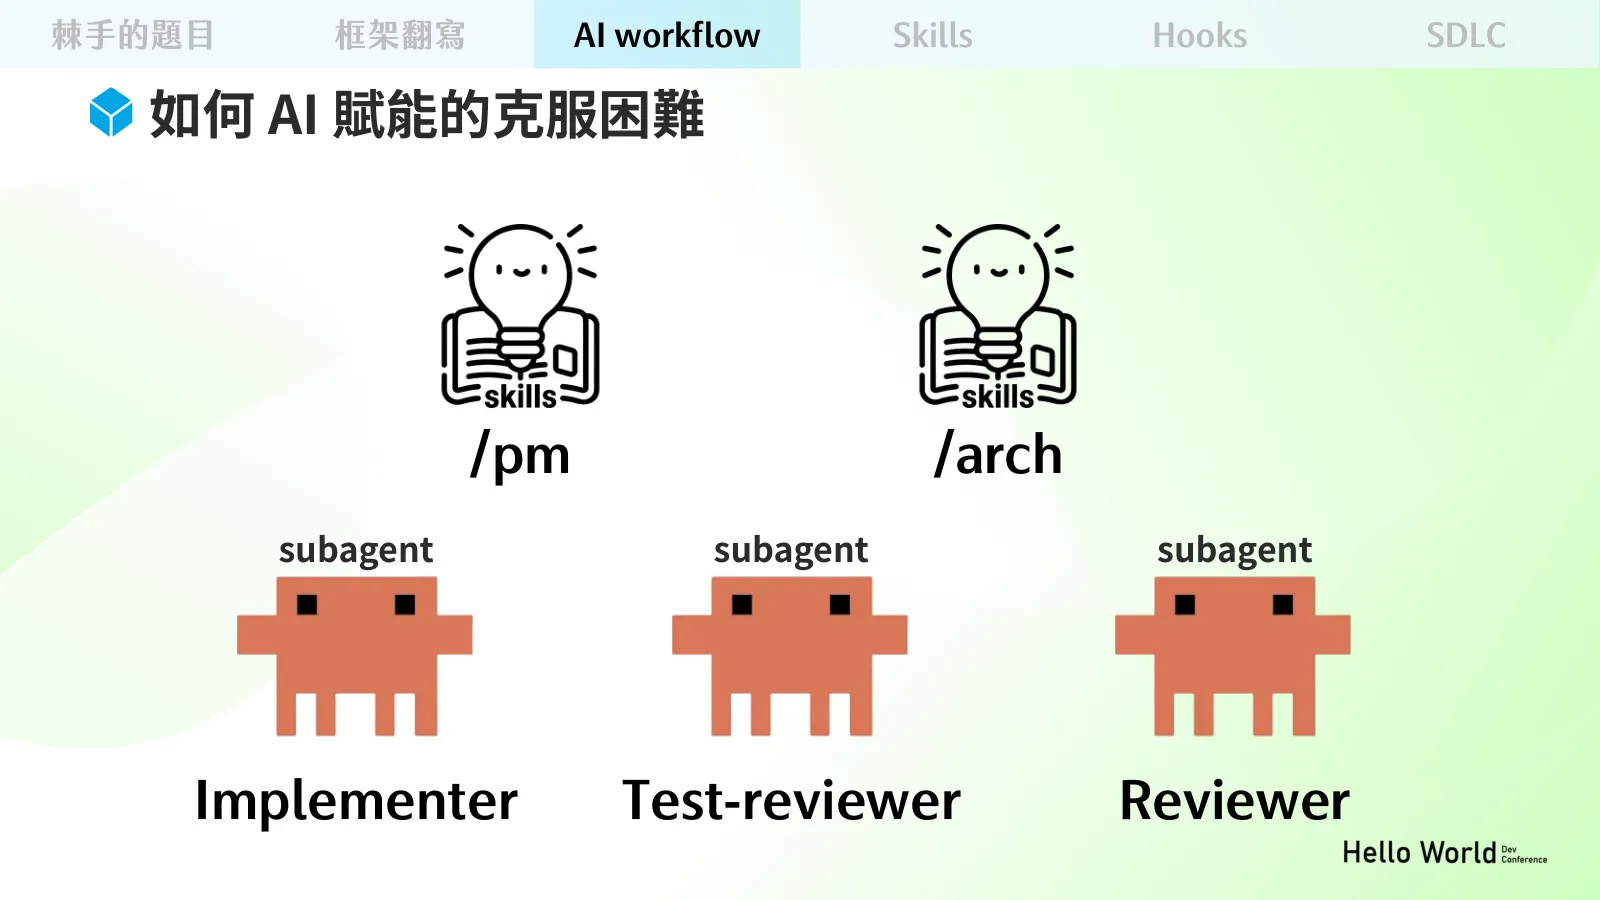
一開始一定是從你跟 AI 說你要做什麼開始,所以第一步是 PM skill,它負責釐清需求,力求這個功能背後的「為什麼」,並設定好 User Journey 和驗收標準,最後產出一份 PM 文件,作為後續架構設計和審查的參考
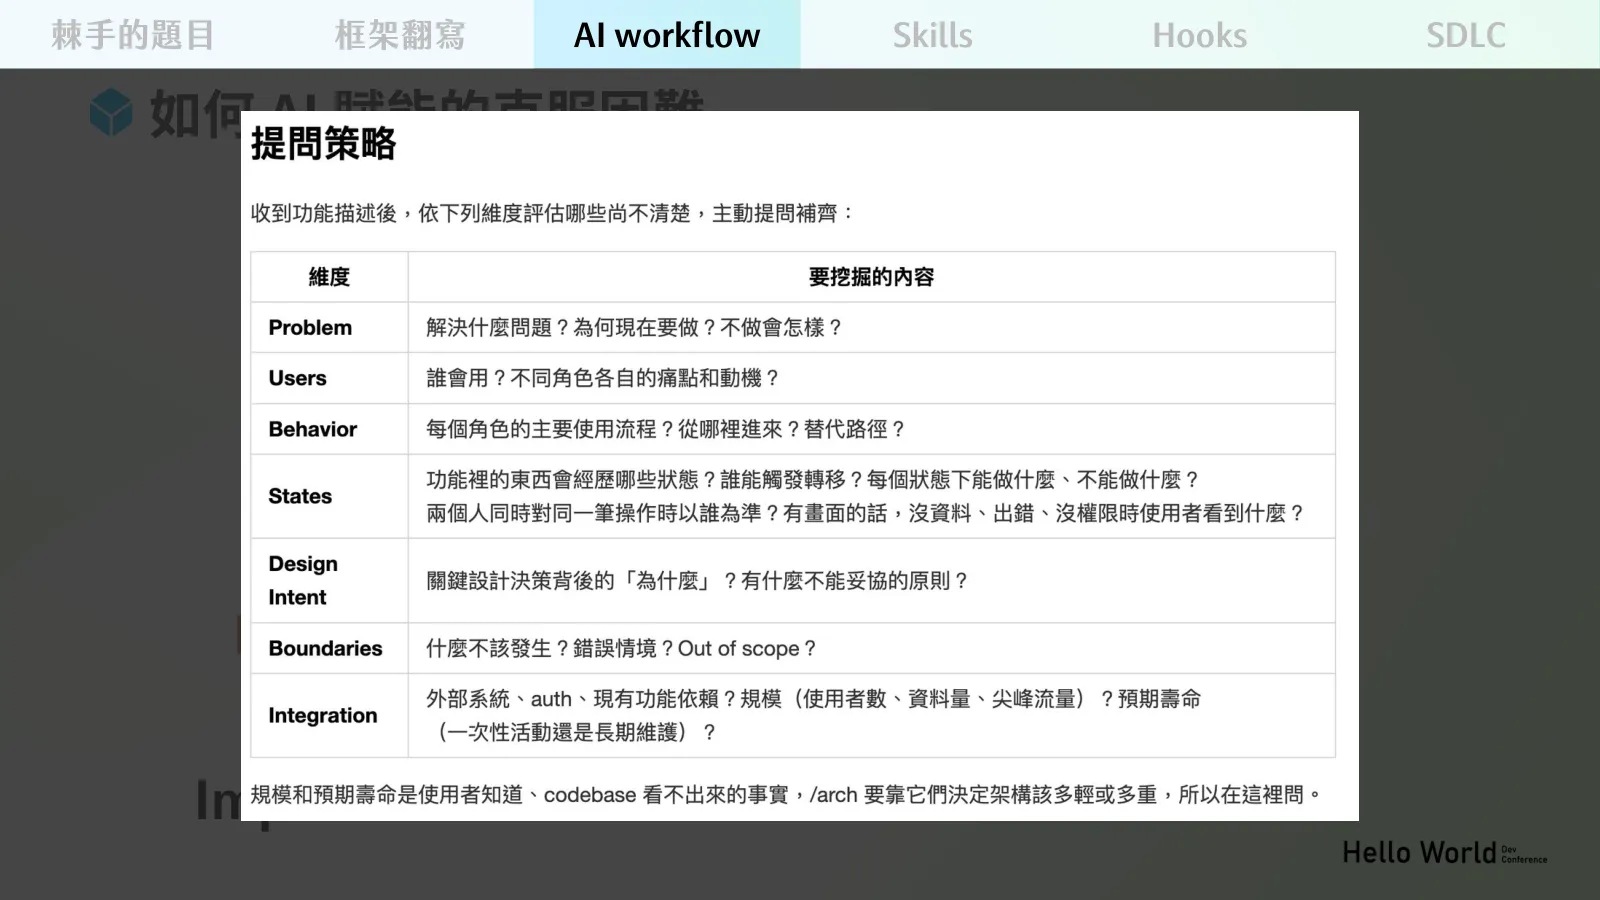
這是我的 PM skill 的內容,可以看到它會要跟我釐清這個開發的功能,使用者到底會怎麼操作,以及狀態怎麼跑、使用者的意圖到底是什麼。這份 PM 文件基本上就是整個開發過程中最核心的內容,後續所有的階段都會從這份文件出發
PM 文件確定之後,再來是 arch skill。它會看這份 PM 文件,盤點當前 code base 既有的 coding style、慣例,以及過去已經抽出來、可以重用的共用層,避免重複造輪子;它也會根據 PM 文件,設計 code 寫完之後測試要怎麼寫、寫什麼內容,最後產出一份架構文件
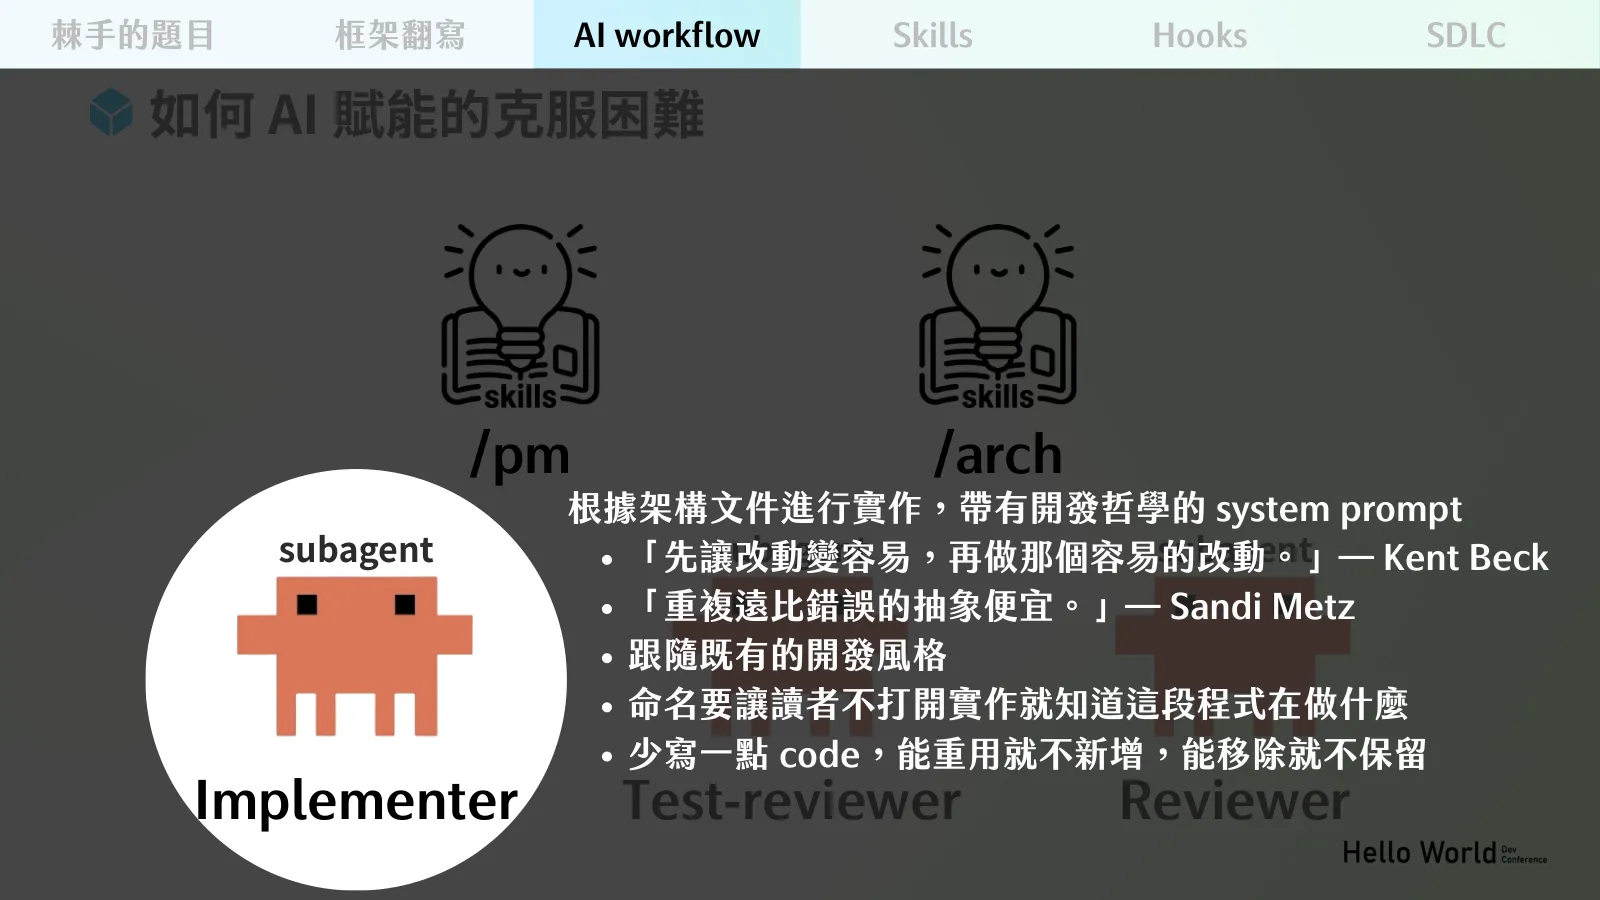
再來就是開始實作、開始寫 code。我定義了一個叫 Implementer 的 subagent,它會根據架構文件實作,本身帶有我寫的、帶有開發哲學的 system prompt,比如 Kent Beck 說的「先讓改動變容易,再做那個容易的改動」;或是當你有兩段重複的東西,但不確定它們是不是真的一樣時,Sandi Metz 說的「重複遠比錯誤的抽象便宜」。還有提醒它跟隨既有的開發風格,特別是命名,要讓讀者,可能是我,也可能是其他 reviewer,不點進去也猜得到這段在幹嘛;還有能少寫一點 code 就少寫,能重用就不新增,能移除就不保留
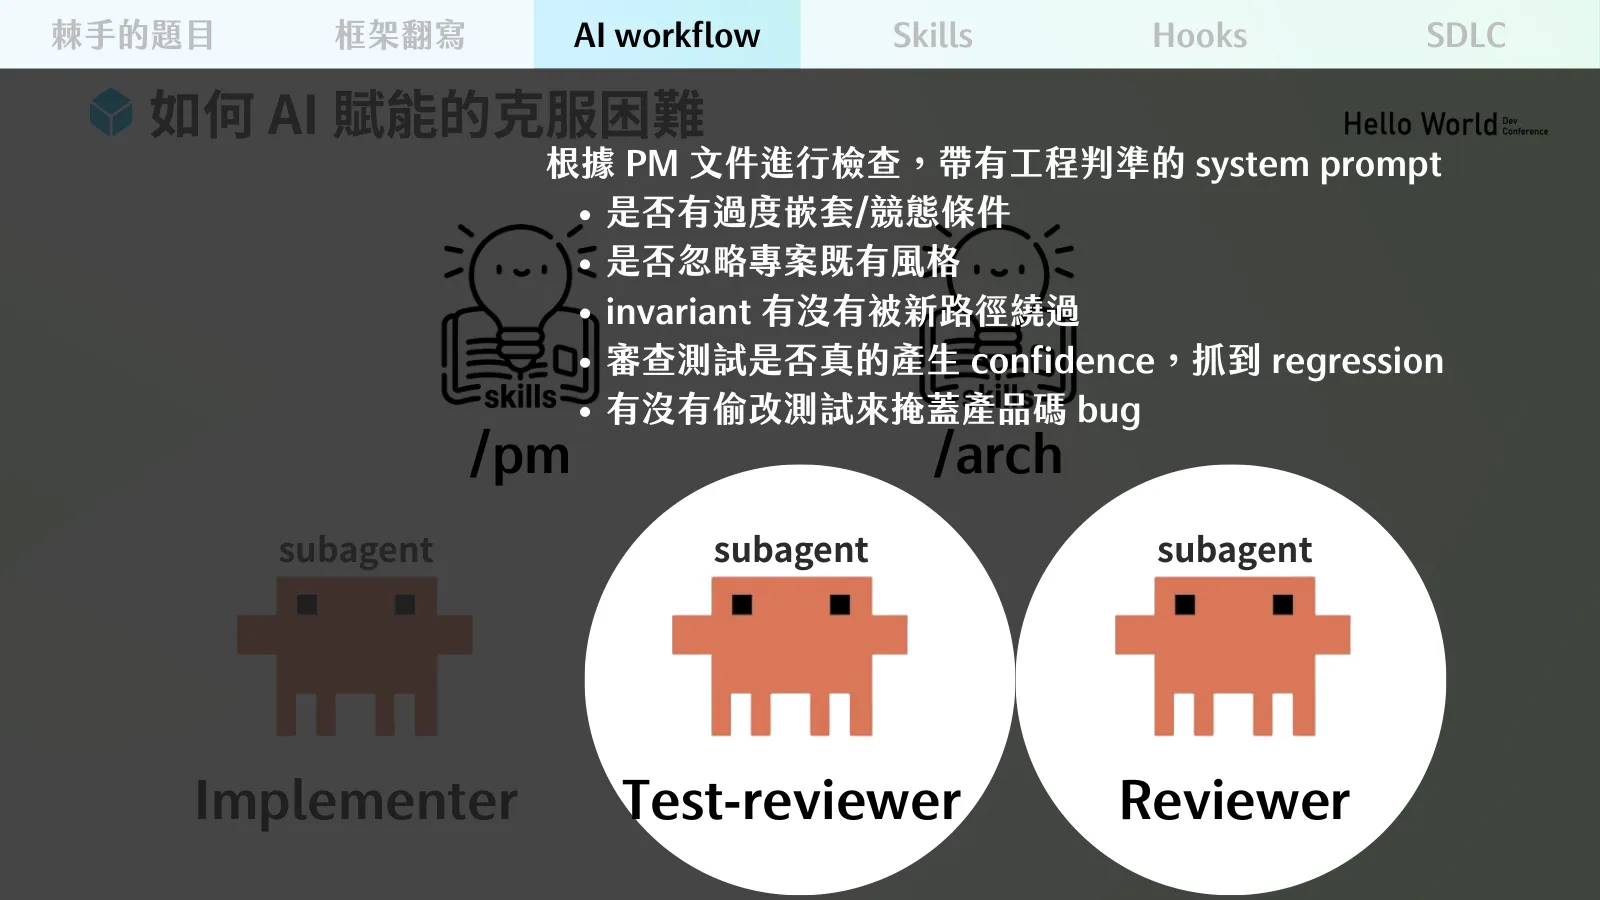
寫完 code 之後,我會先讓 AI 跑第一輪 review,不是我自己先看,這同樣是透過 subagent 做到的,也帶有我寫的工程判準。我有兩個 reviewer,一個看實作、一個看測試
看實作的會檢查 Implementer 寫出來的 code 有沒有過度嵌套,比如跳轉了兩層,結果兩層都在做轉發;有沒有 race condition,甚至 N+1 這種問題;有沒有忽略專案既有的 coding style、確實有使用共用層,或是有沒有寫翻譯式註解;或是有些 invariant 應該要封裝,結果直接寫在 application 層
審測試的時候,我會讓它檢查前面寫的測試是不是真的有用,因為 AI 有時候寫測試只是為了讓數字好看,也就是讓 coverage 變多,所以會讓它檢查測試是不是真的反映使用者意圖、有沒有抓到 regression,甚至 AI 是不是為了讓測試通過,自己偷改了測試
測試交換的是 confidence,不是 coverage 數字,核心問題是:這個測試刪掉後,會失去什麼保護?
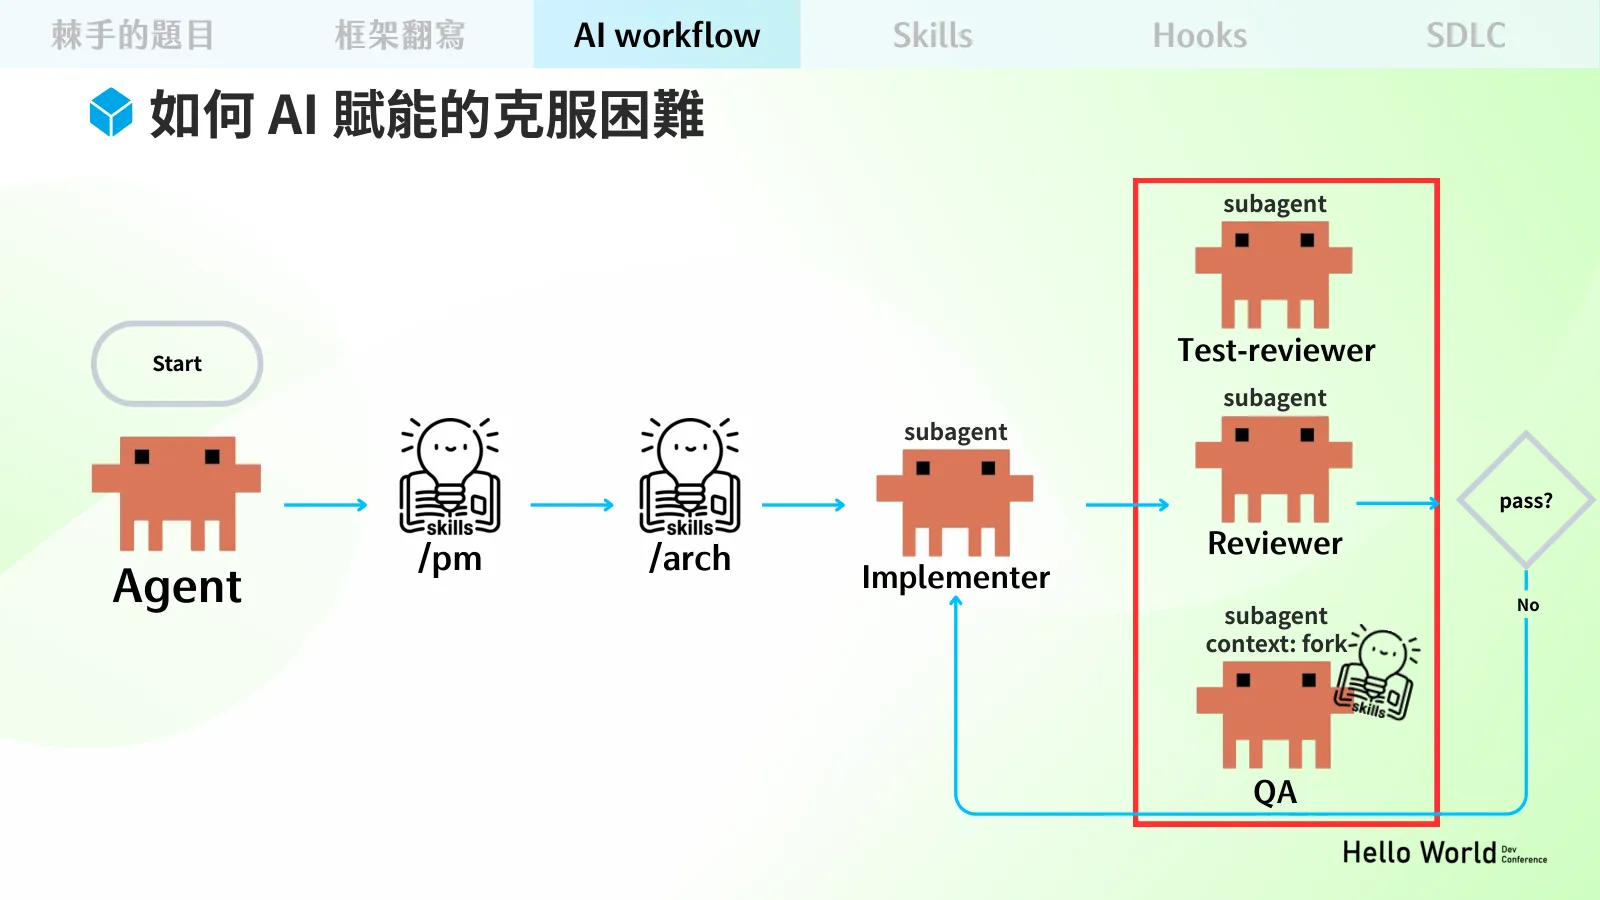
整體的流程會長這樣:從主 agent 使用 PM skill 釐清需求,再用 arch skill 寫出架構文件,然後派 subagent 實作,實作完 review,這三個是一組的,可能跑一輪或兩輪 review,到我滿意之後,再跑一次 QA subagent,把服務完整起起來做 API testing,確認沒問題這樣
看到這邊大家可能會覺得,你的 skills 一次要產兩份文件,一支 API 不就好多份,真的每份都有認真看嗎?這其實是現在很多人開發會碰到的問題,可能走 SDD,但文字多起來其實也很少在看,變得很像在過場
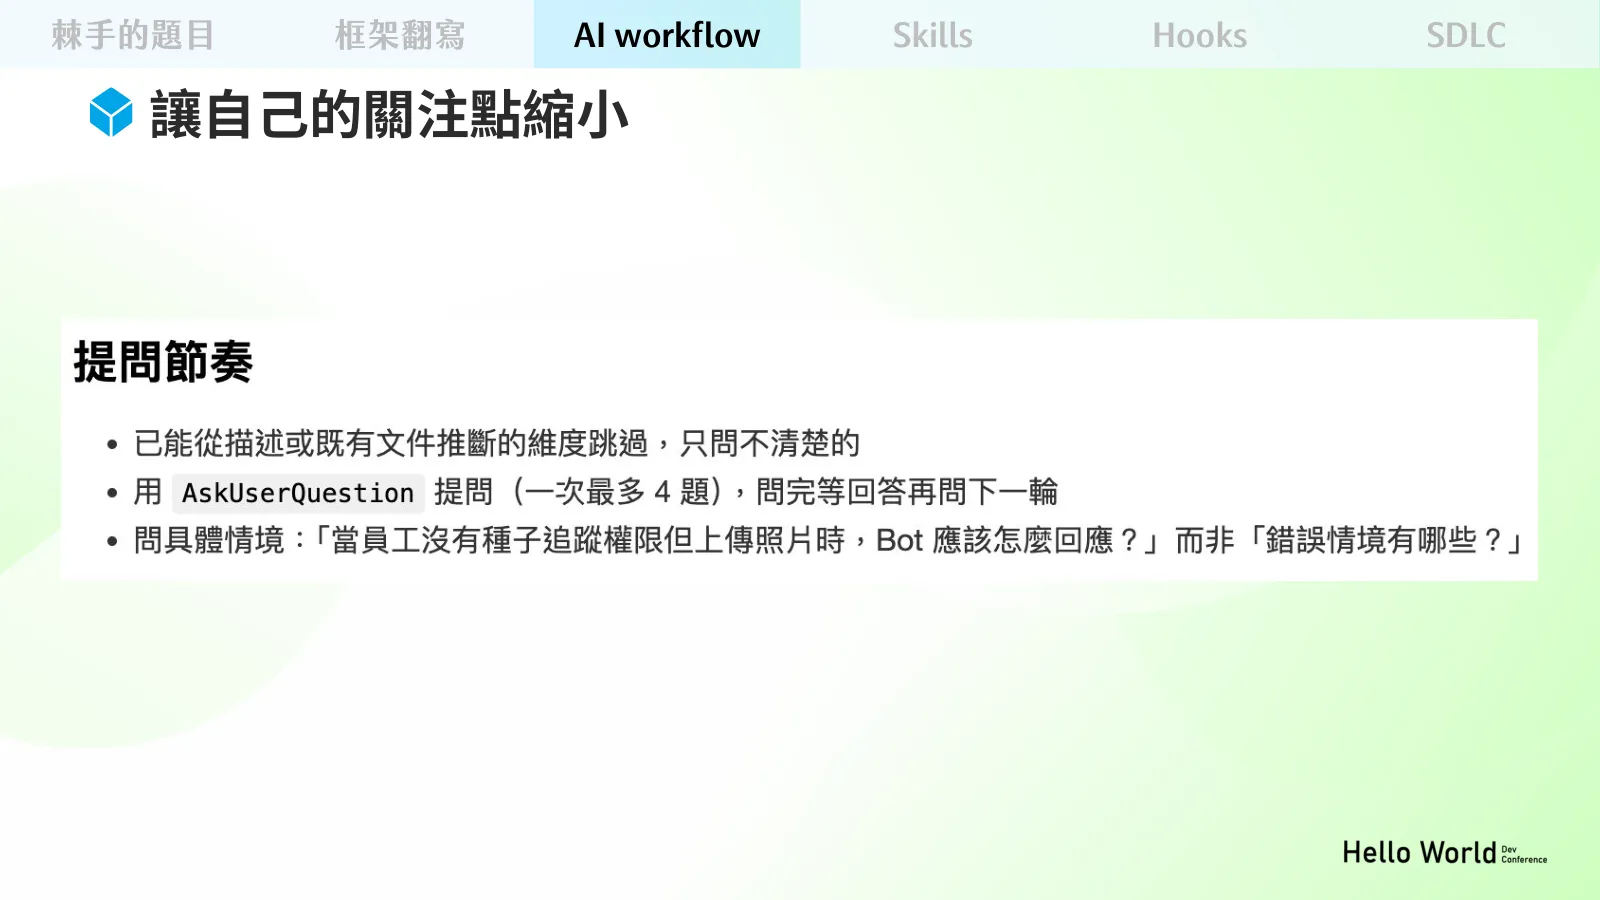
對於這個問題,我自己的 solution 是讓 AI 一步一步對我提問,讓它幫我分段,不是一次把問題丟給我。我覺得可以實踐的是使用 AskUserQuestion 這個工具,主流一線的 Coding Agent 基本上都有支援(Claude Code、Codex、GitHub Copilot CLI 等等),幫我們把關注點聚焦在某一個問題,然後一題一題來,一輪最多四題,可以很多輪這樣。然後要求它問具體的使用者情境,讓使用者預期怎麼做被記錄下來
組成 workflow 的是 skills、subagent、hooks
到這邊為止,可以看到我的 workflow 很大一部分都是透過 skills 和 subagents 搭起來的,因此接下來想分享組成這套流程的元件有哪些,以及它們怎麼搭配。我先從 skill 跟 subagent 的搭配開始
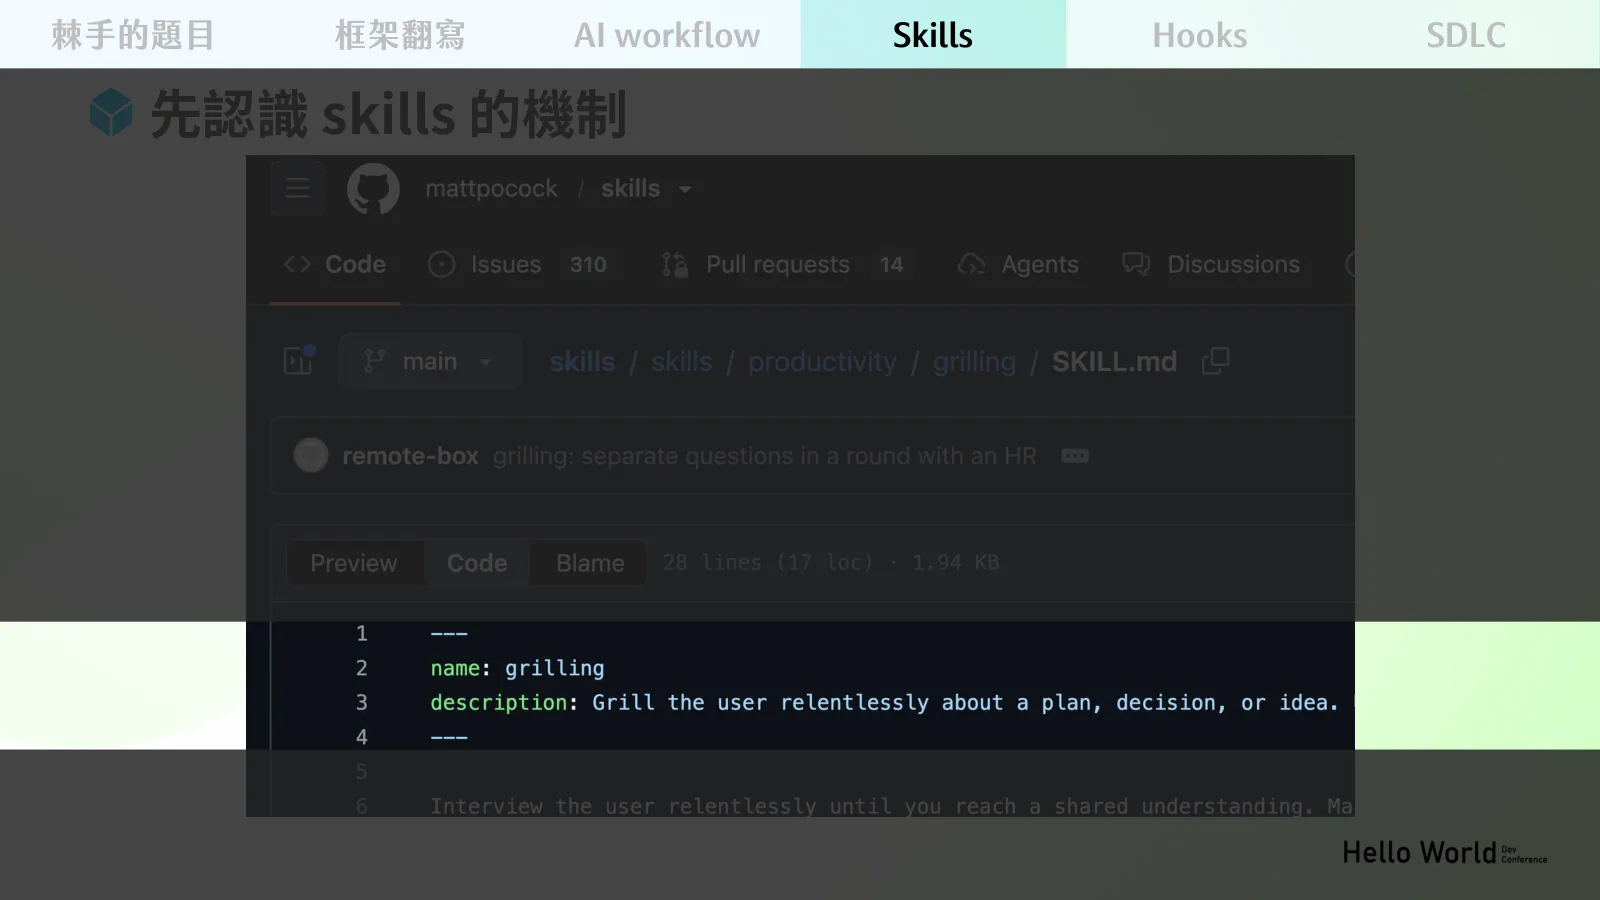
相信 grill me(現在叫 grilling)或 wayfinder 這兩個 skills,或是再更前一陣子的 superpowers,大家應該都很熟悉,但前面我提到的這些 skills,其實大部分都只有寫 name 和 description
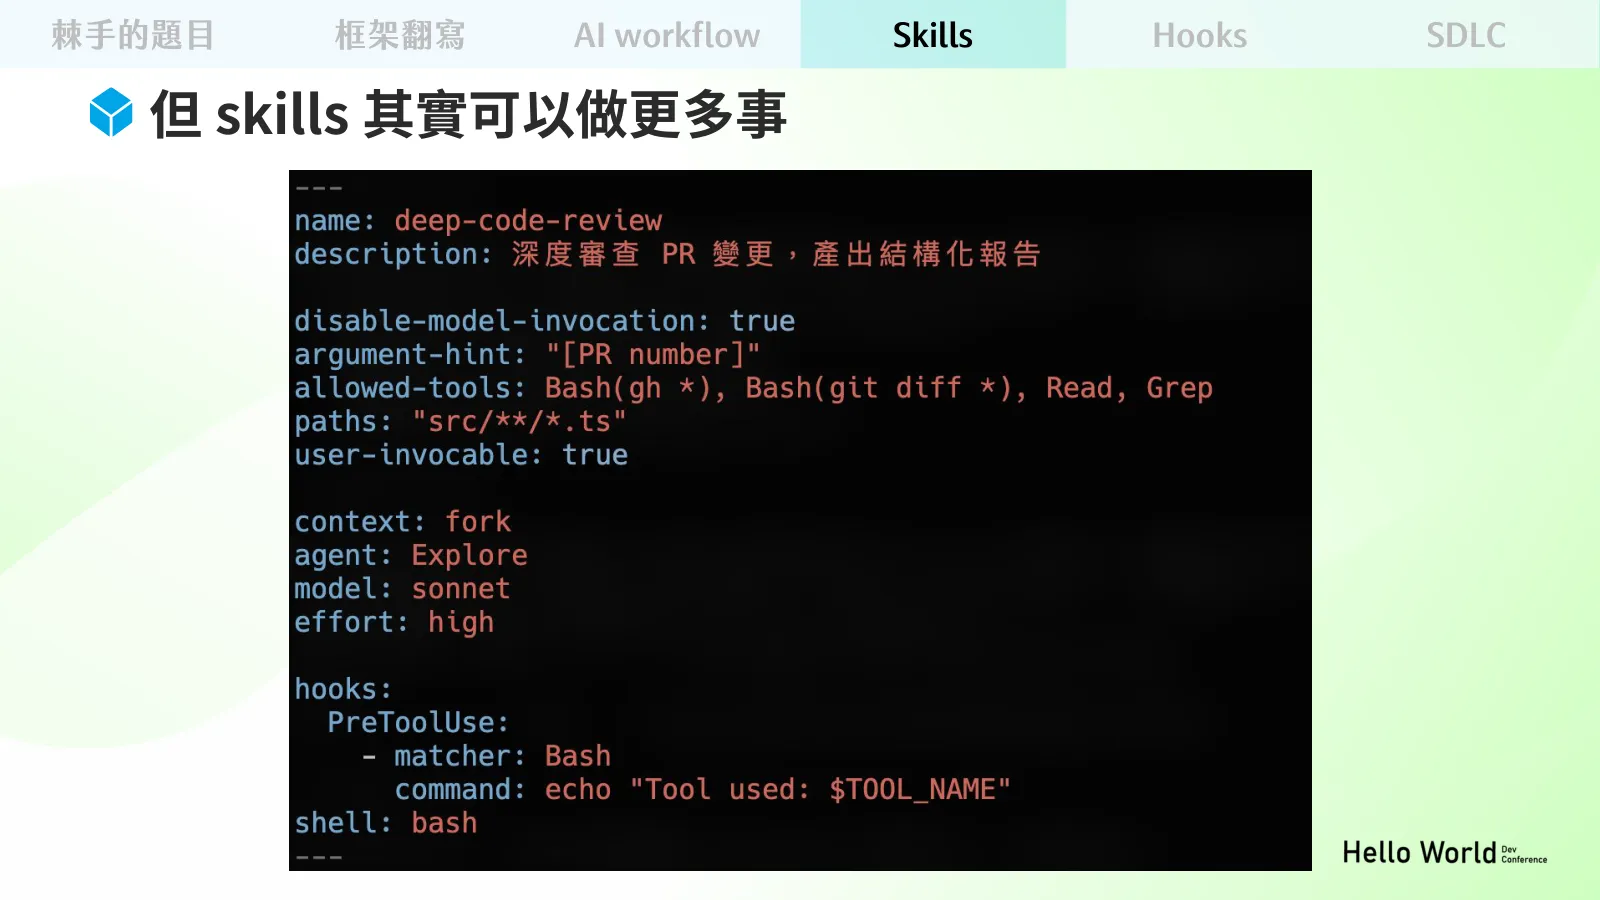
但其實 skills 可以做更多事,可以使用的參數有這些:可以根據 skills 的類型設定觸發的 path、要不要讓模型觸發、hook,甚至用 agent 等等
其中我覺得這組是比較值得分享的,也就是 skills 其實可以指定一個 agent 來跑,並且設定 context 是否要 fork。這裡的 fork 不是繼承主 session,而是全新的對話,fork 出去的 skill 拿不到主 session 的對話紀錄,只有 skill 本文作為 prompt,啟動一個乾淨的 session,我通常稱呼它為 fork agent skills
但這樣 fork agent skills 跟單純定義 name + description 有什麼差別呢?以 code-review 的情境來舉例,這兩者分別會有一些 trade-off
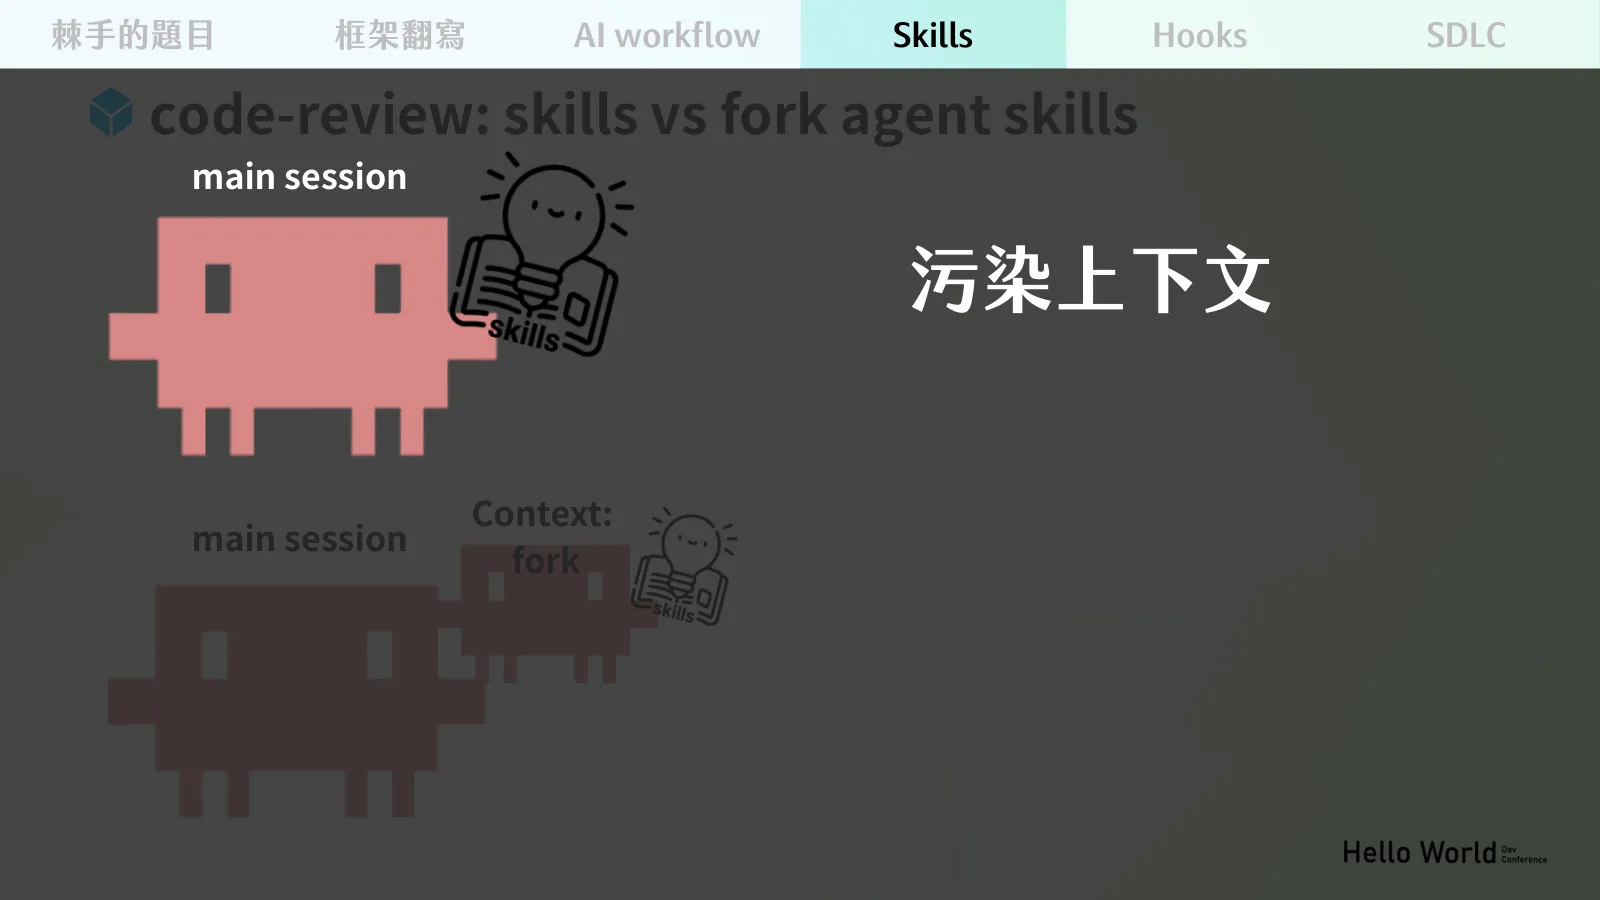
單純定義 skill 會污染上下文,通常一次 session 可能會有很多個 skills 疊在一起,但不見得都跟同一個任務有關
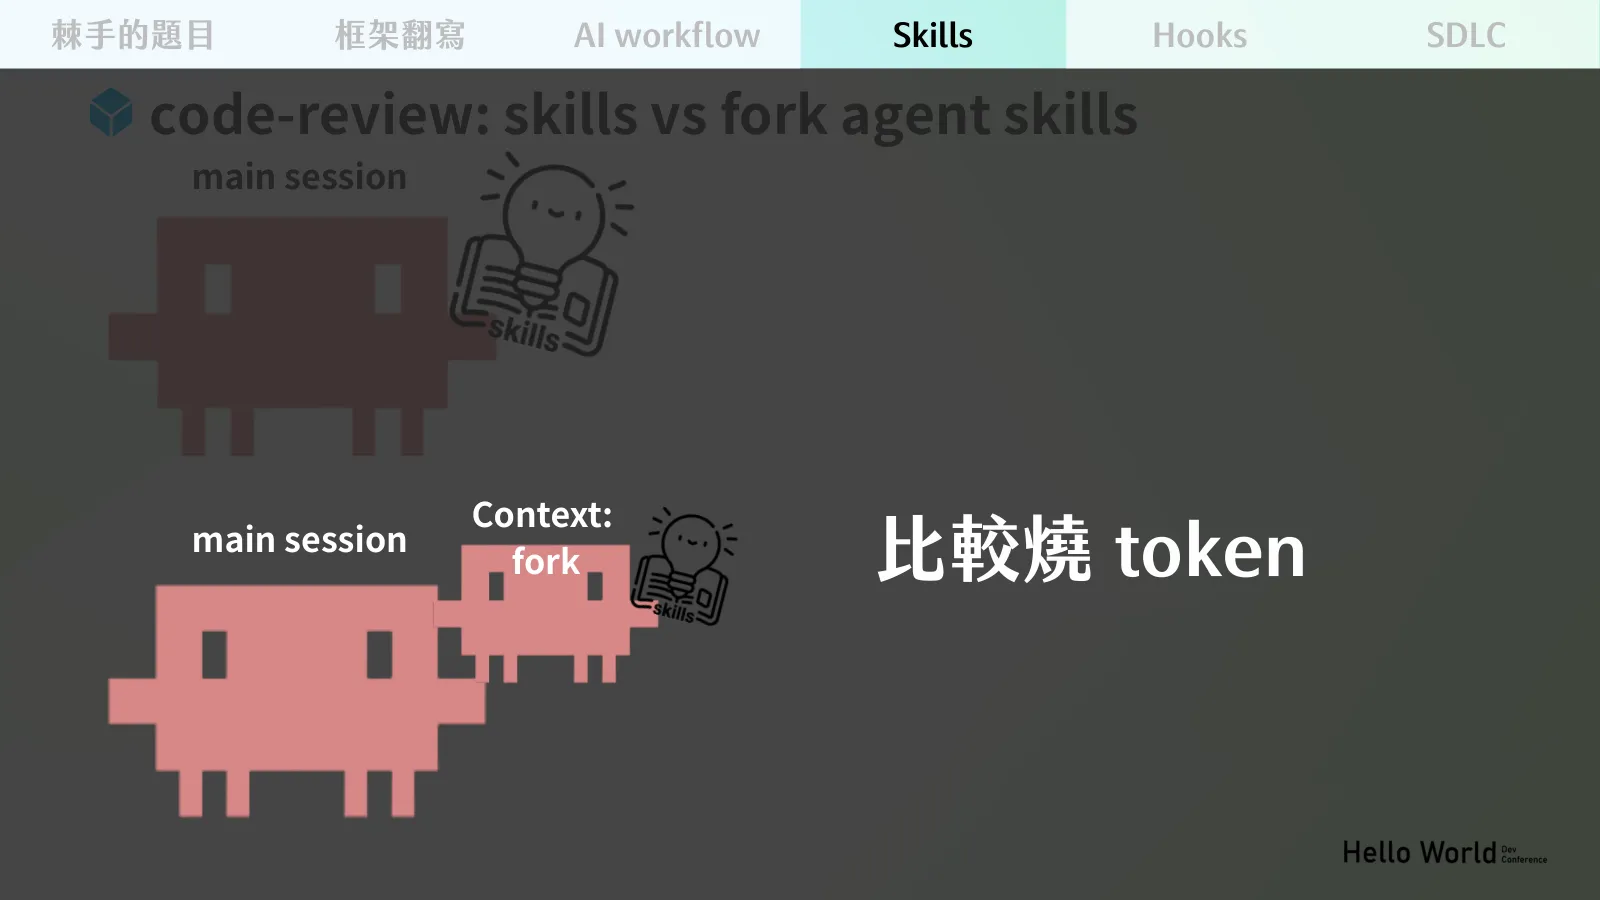
fork agent skills 的 trade-off 自然就是比較燒 token,畢竟起了一個乾淨的 session
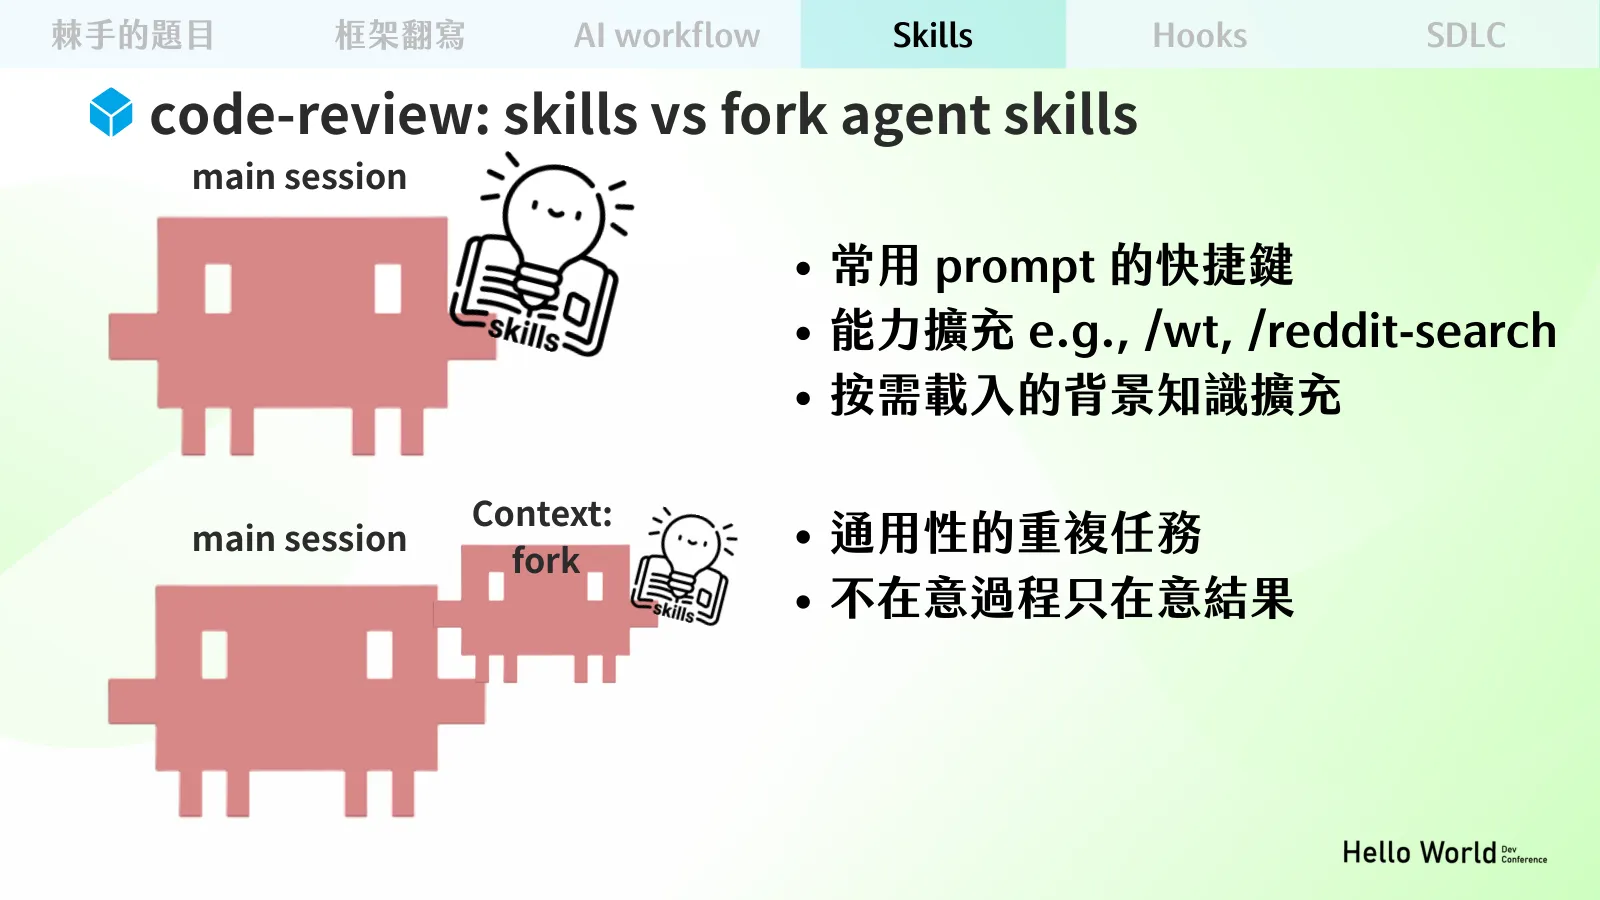
我認為兩種 skills 的設計目的不同,以我來說,我會這樣區分:一般 skill 用在常用 prompt 的快捷鍵、能力擴充,以及按需載入的背景知識。能力擴充像是 /wt,觸發後會幫我做資料庫和環境的隔離、把套件都裝好;或是 /reddit-search,輸入關鍵字,背後的腳本就會上 Reddit 幫我搜尋
fork agent skills 則用在通用性的重複任務,不在意過程、只在意結果。像 code review,我不在乎它到底看了哪些檔案,只要告訴我 code 哪裡有問題就好,而且不管在 A 專案還是 B 專案都一定用得到
再來想跟大家談談 hooks。hooks 這個功能,在 AI 的語境下基本上跟軟體工程的 hooks 意思差不多,比如 webhook、pre-commit hook,意思是條件成立時自動發生的行為。hook 推出的目的,是讓 AI 能夠被一套硬性的規則控制,而不是單純仰賴自然語言,祈禱 AI 真的不會做什麼事
大家最常見的例子是,比如不准讀環境變數、改完 code 一定要跑 lint 等等
但我有個不一樣的用法,我有某些自己的習慣,例如測試我喜歡用 BDD 的命名。這件事情其實 skills 也能做到,但我認為 skills 除了你的 description 要寫得好,也仰賴模型當下的注意力,而我其實不太相信 Claude 能在寫測試時自己讀 skills,但也不想每次要改測試都手動觸發 skills
有沒有可能讓它在改測試相關檔案的時候,像是自動觸發 skills 一樣,能夠自動提醒 AI 我的命名習慣?
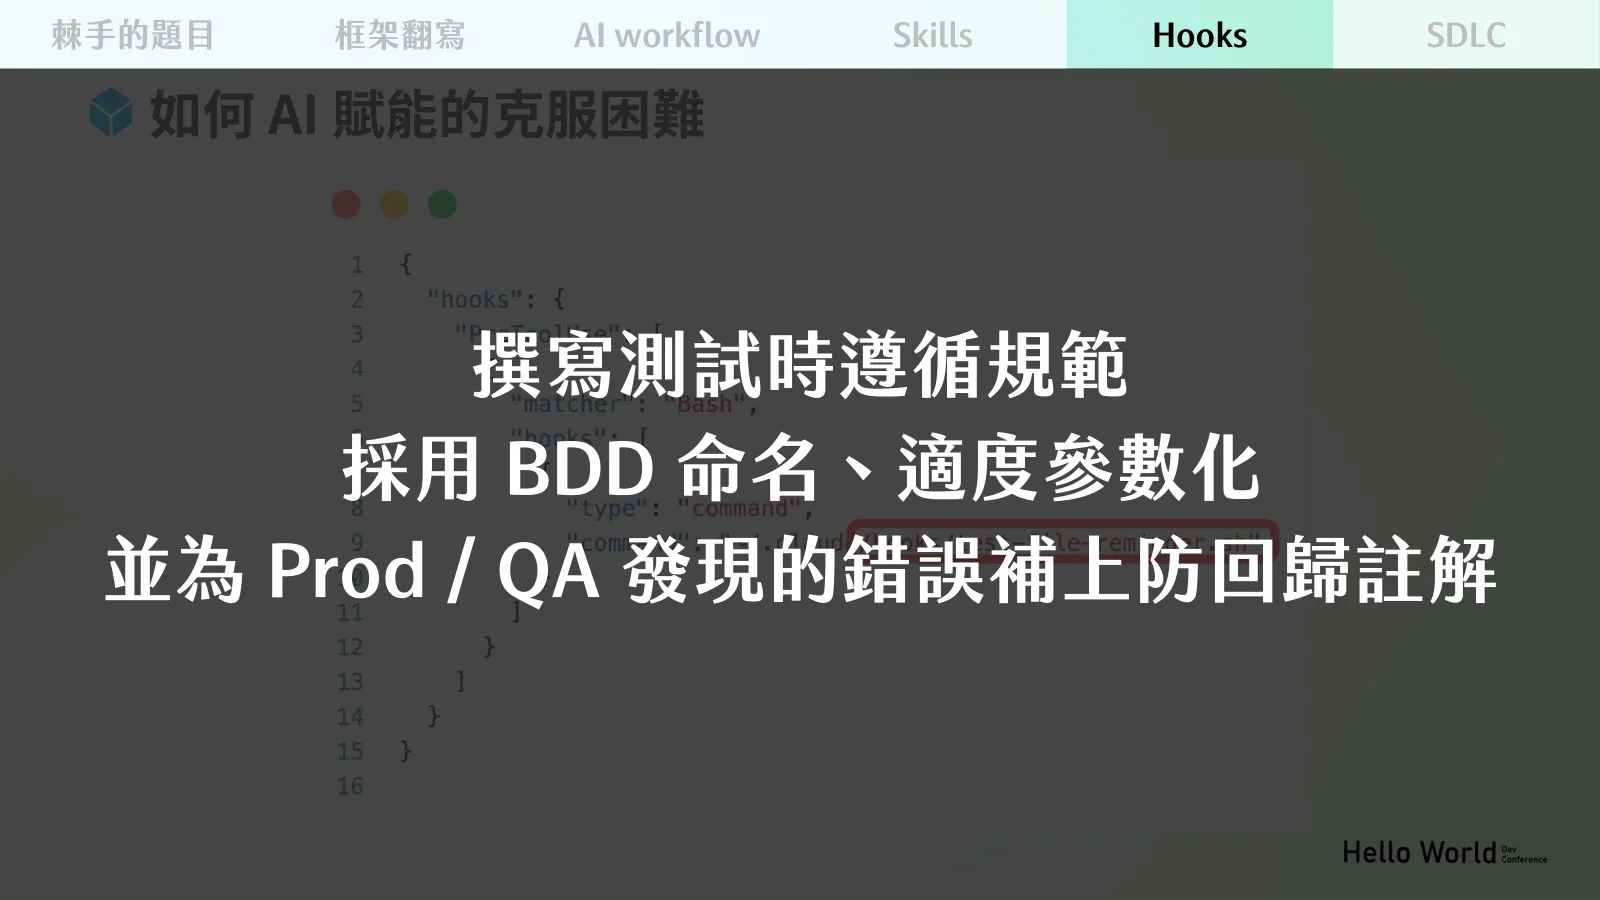
所以我透過 hooks 來自動幫我下 prompt,改測試檔時 Claude 會自己被提醒:撰寫測試時遵循規範,採用 BDD 命名、適度參數化,並為正式環境或 QA 發現的錯誤補上防回歸註解
小結一下前面翻寫階段碰到的問題,以及我怎麼解決:對於古蹟翻寫,建立測試環境是第一件事,即便有原始碼,我也會把系統當黑盒子去敲;再來是在 AI coding 時,善用 hooks、skills、MCP 這些機制,也就是所謂的 harness,來控制 AI 的輸出;最後,現在走 SDD 之類的開發流程一定會有非常多文件,很多 AI 不清楚、要跟你確認的地方,可以讓 AI 拆分關注點,一次確認一件事,比較不容易淪為過場
過去沒有 AI 時 SDLC 裡最常被犧牲的測試,是 AI 時代最不該犧牲的
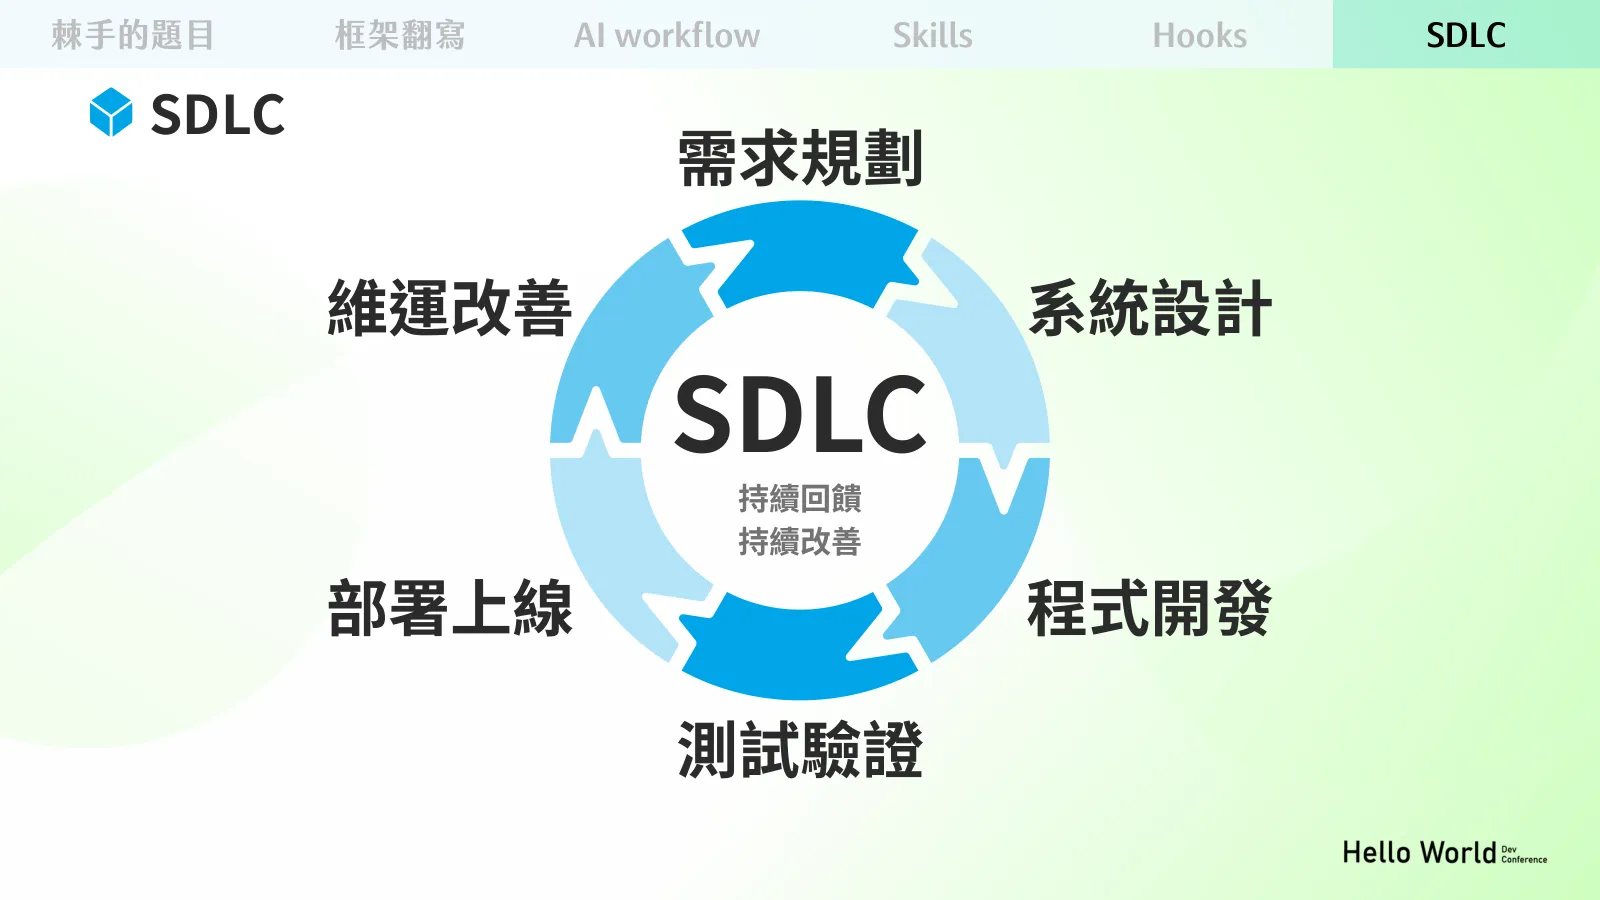
聊完我怎麼做古蹟翻寫之後,再來想跟大家聊聊 SDLC。我相信這個 SDLC cycle 大家應該再熟悉不過,沒有 AI 的時候,這張圖應該是理想很豐滿,現實很骨感,實際在執行的時候總有一些東西會被犧牲
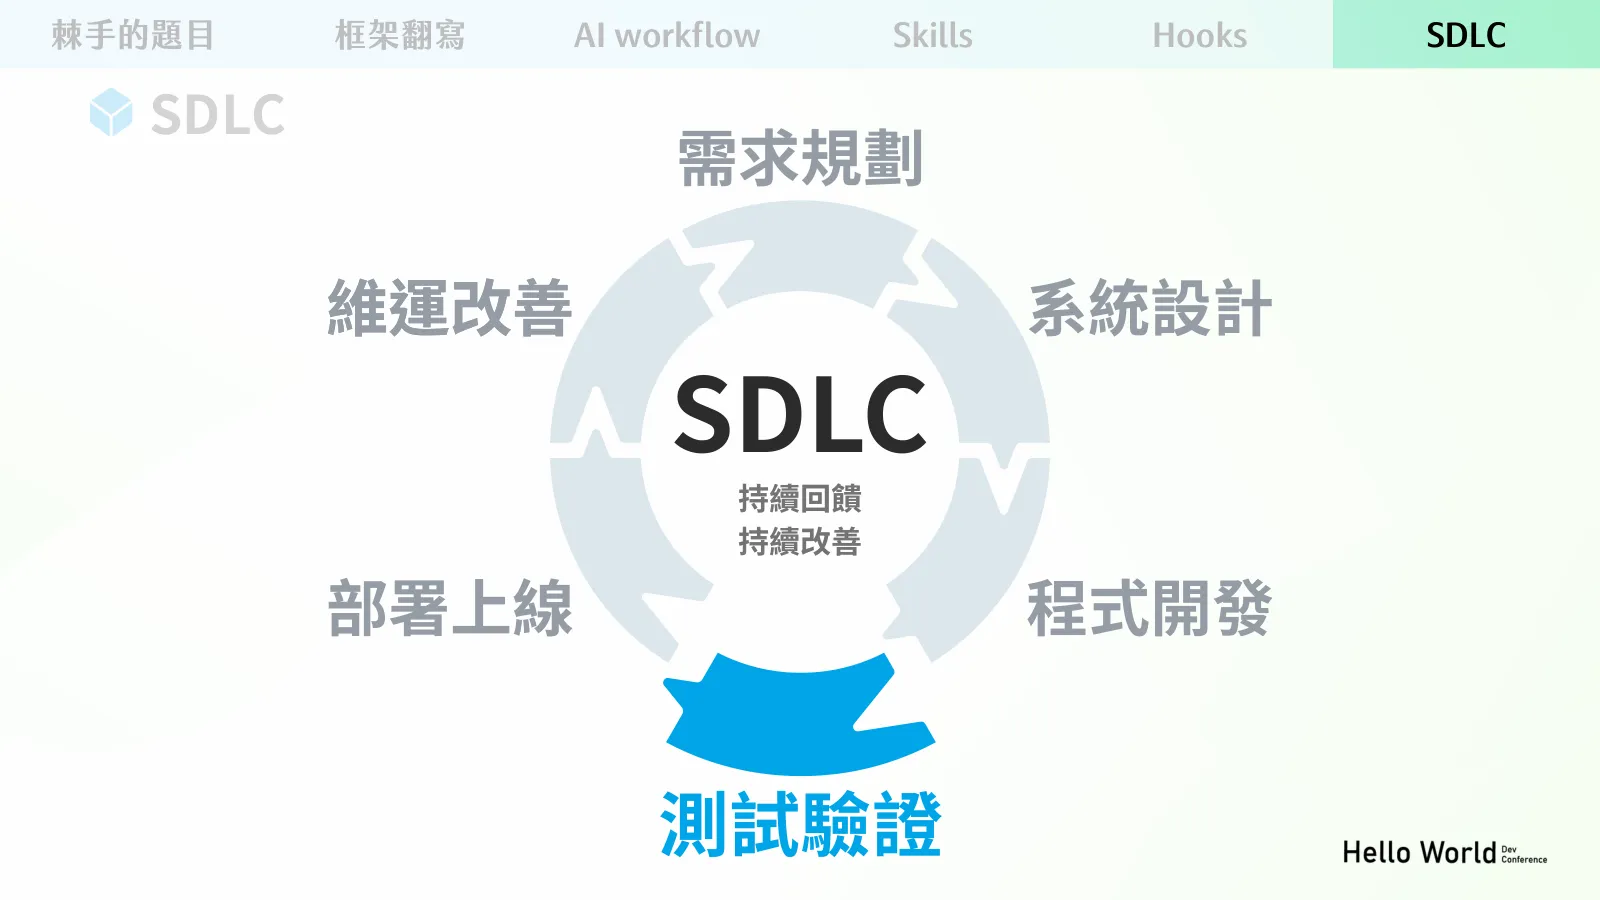
像是測試驗證,我認為它肯定是被犧牲的最大受害者
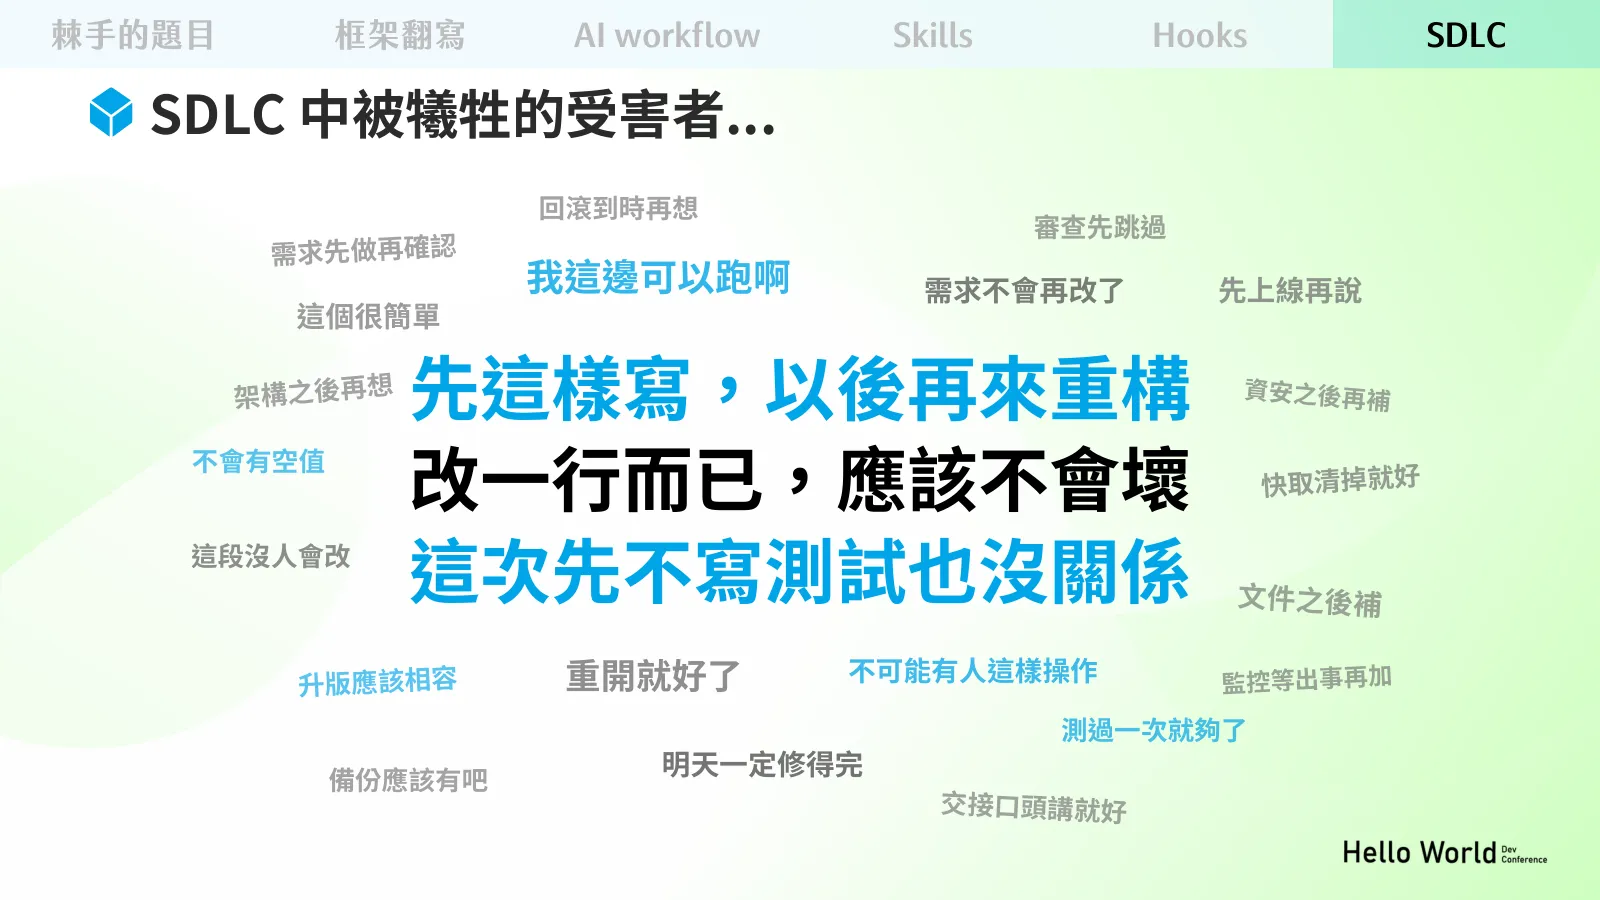
當然其他階段多少也被犧牲過一些,像是先做之後再跟客戶確認、測試先不寫或沒時間寫、是個人都不會這樣操作、這不會發生、啊我這邊可以跑之類的,但最經典的肯定是躺在 code 裡的 TODO、workaround 跟缺少的測試
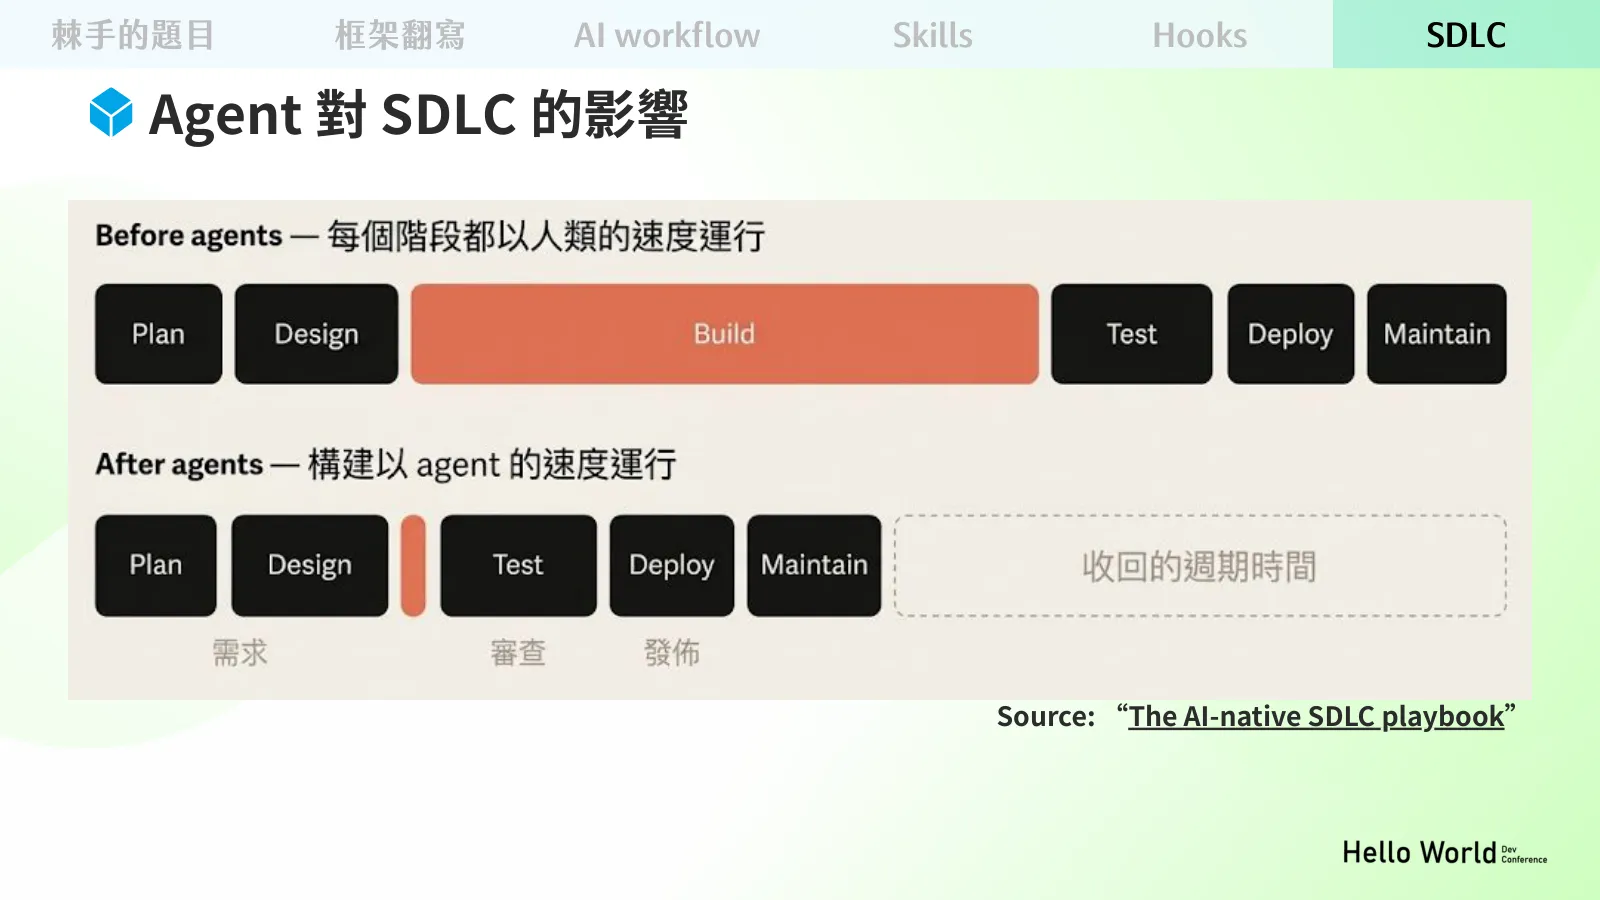
這些情況會發生,很大一部分源自於過去在手搓的時候,需要花費大量的時間來撰寫程式碼以及閱讀程式碼,程式碼的產出成本是非常高的。但有了 Agent 之後,產出程式碼的速度變得非常快,甚至我也聽很多前輩說他幾乎已經不看 code,或是大概掃過沒什麼問題就放行了
那既然寫程式碼的時間變短了,身為一個軟體工程師,在我已經沒辦法逐行看 code 的情況下,這些省下來的時間我要怎麼用來驗證 AI 的產出、維持架構和程式碼品質?
我認為答案就是過去最常被犧牲的測試驗證。測試的初衷是確保軟體的行為品質、可靠性和穩定性,還有很重要的是,測試讓你能充滿信心地修改程式碼
當你能充滿信心地修改程式碼之後,就可以放心的重構,來消除程式碼的臭味。以我自己的 AI workflow 來說,我就在這個迴圈中納入重構
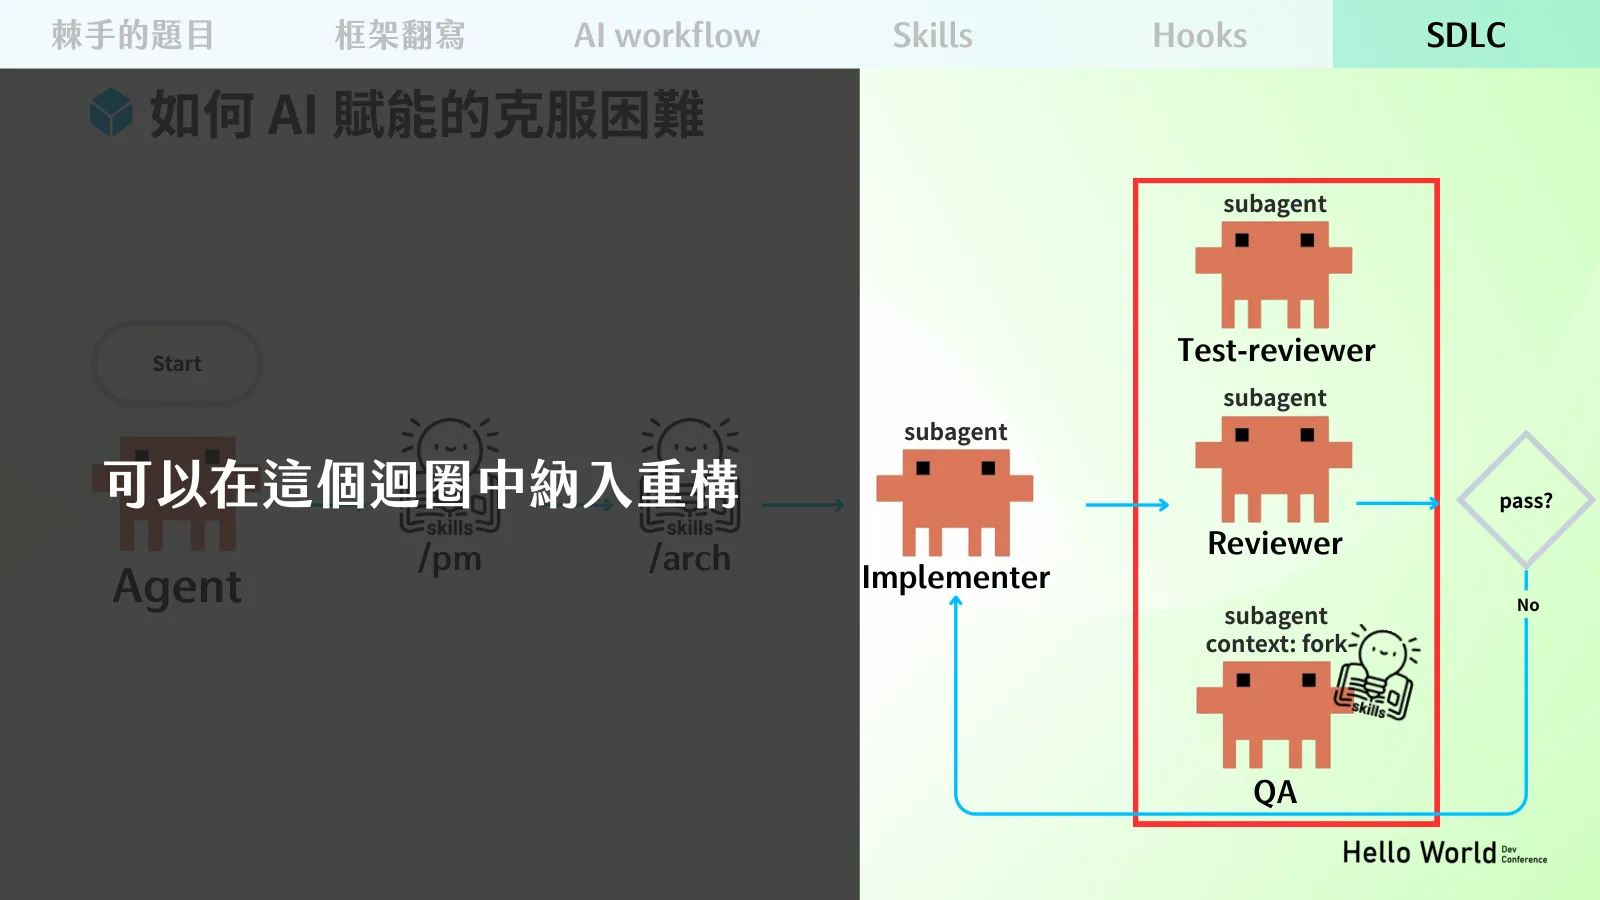
當然剛開始起步絕對是最難的,可能看不到什麼效果,尤其當你在 legacy system 的時候。因為就像我前面分享第二階段的問題一樣,AI 很容易被周圍的 code 影響,畢竟 code 也是上下文的一環
臭臭的 code 會影響 AI,但同樣的,香香的 code 也會。如果在開發完成的同時接著重構,每次在碰到的地方開始一小塊一小塊的建起規則,這樣堅持整理下來,當周圍的 code 開始有紀律之後,後續 AI 再怎麼改,也八九不離十你辛苦維護的品質與架構
但我知道要寫測試,AI 也知道要寫測試,怎麼確認 AI 寫的測試真的有用?可能會說要看測試,當然看測試一定是最直接的方法,但人力是有限的,不可能一直看、一直跟它改、改完又看
我認為要讓 AI 能一直寫出好的測試,答案是回歸需求本身。所有的軟體開發都是為了解決問題,所以我前面的 AI workflow 才會以 PM skill 產出的文件作為核心,當文件有釐清使用者的意圖以及會怎麼操作,AI 寫出來的測試才是真的有用
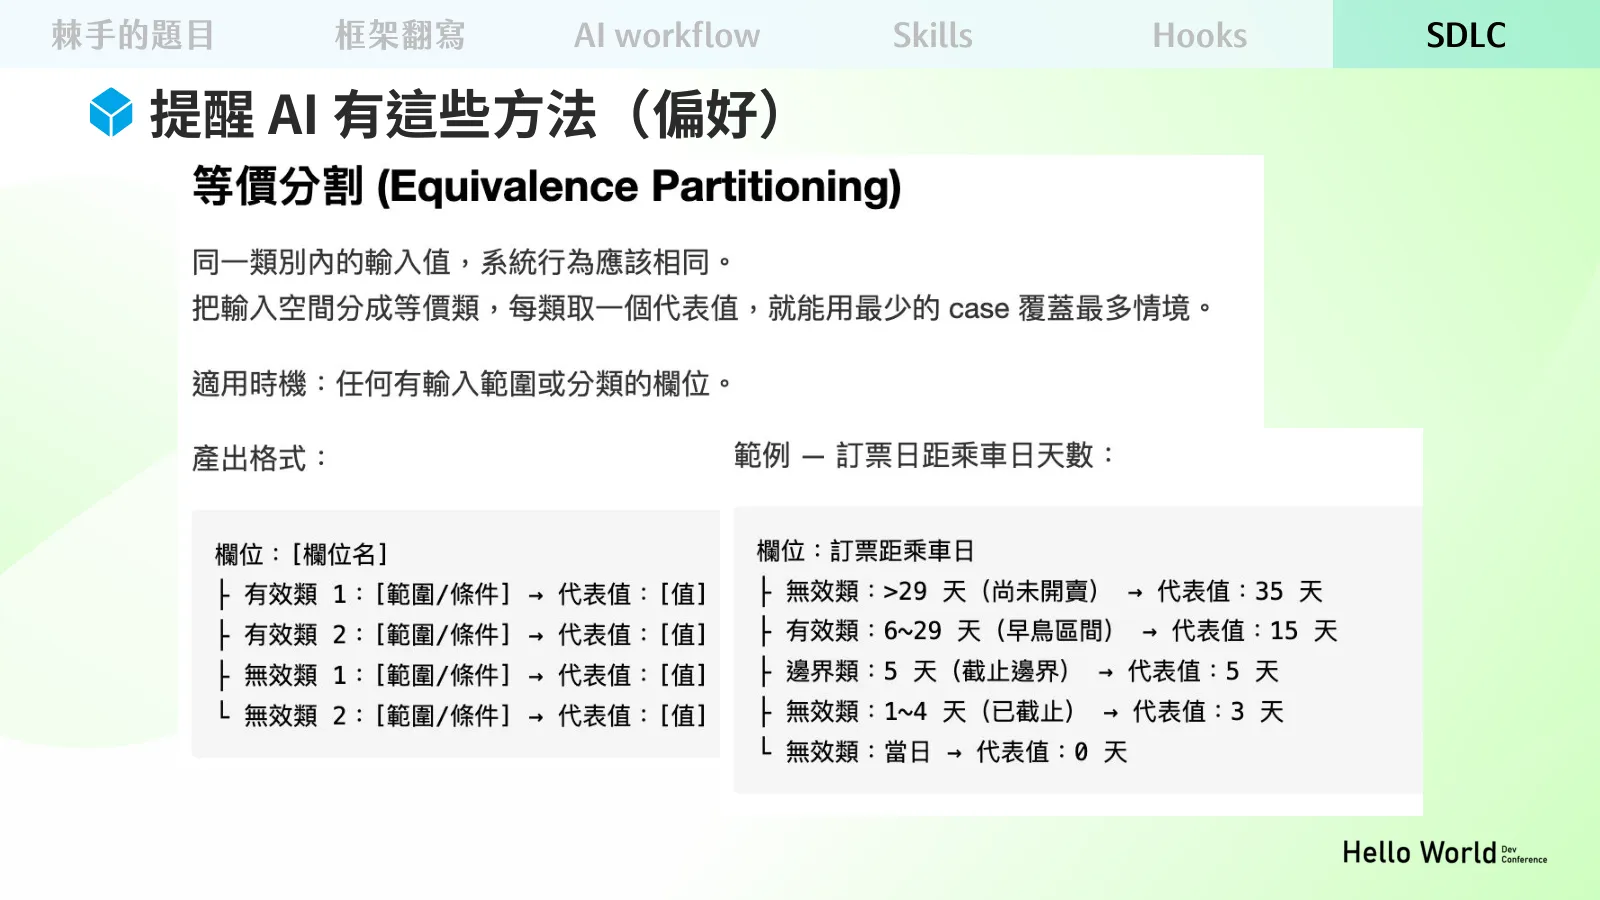
還有我認為可以提醒 AI 使用這些測試的方法論,讓 AI 寫出來的測試品質更好,像是等價分割,每個條件取一個代表值
或是決策表,測試前先畫出決策表,找出所有會影響結果的組合
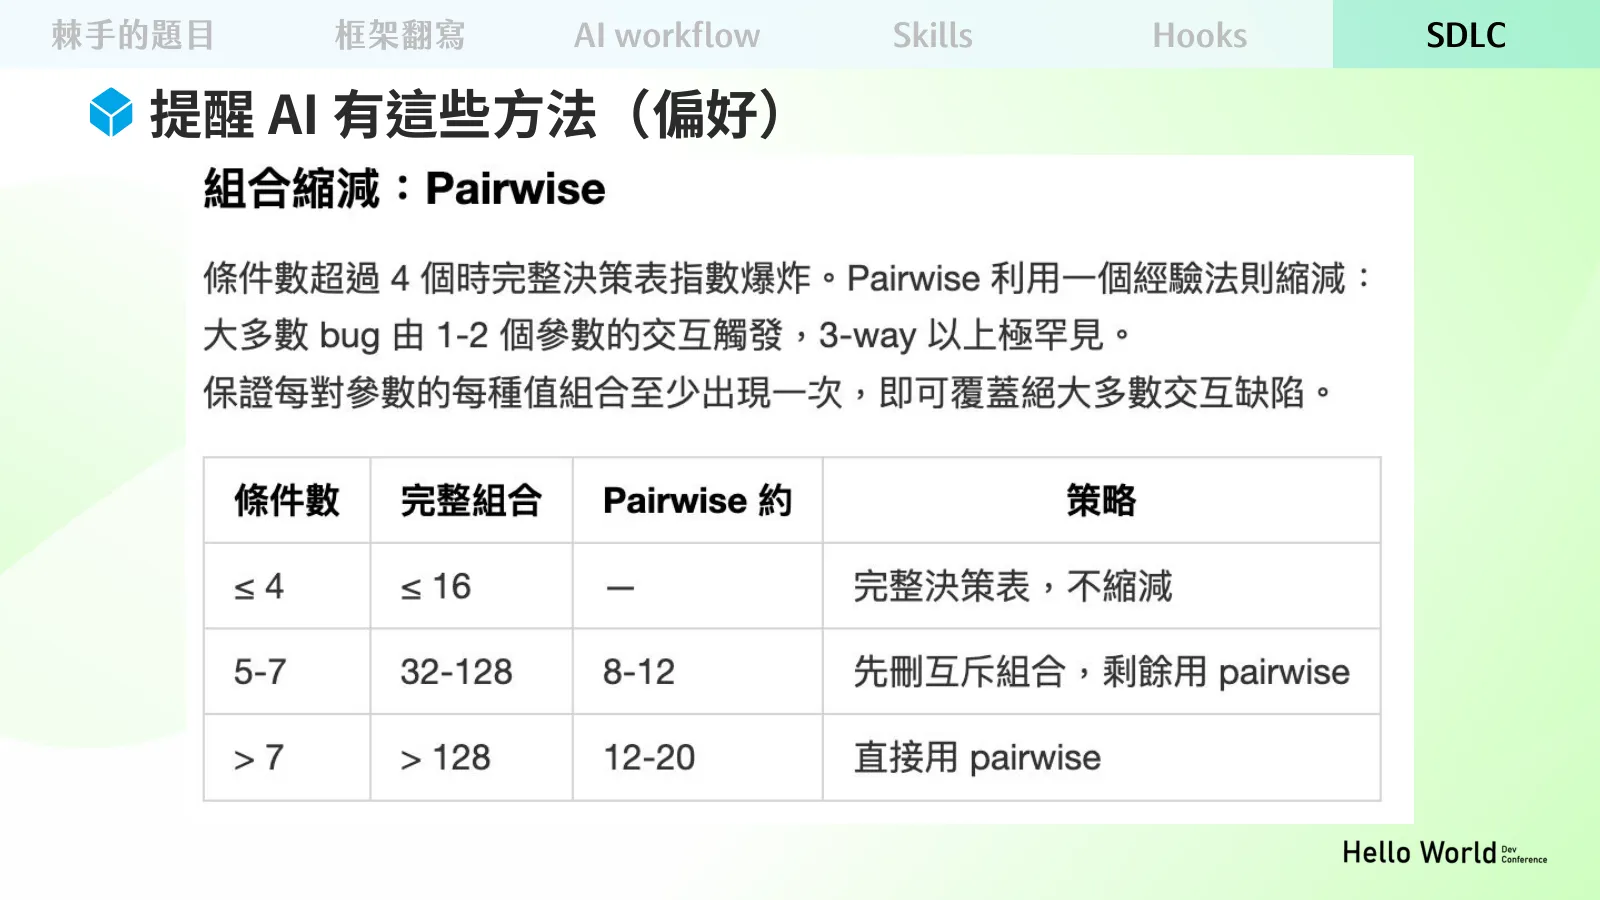
但當組合太多時,透過組合縮減,挑選適當的組數來涵蓋最多的 case。因為大多數的 bug 是一兩個條件互相觸發,三個條件同時觸發的很少見,所以組合太多的時候,可以用這個方式減少測試的數量,又蓋得住大部分的情境
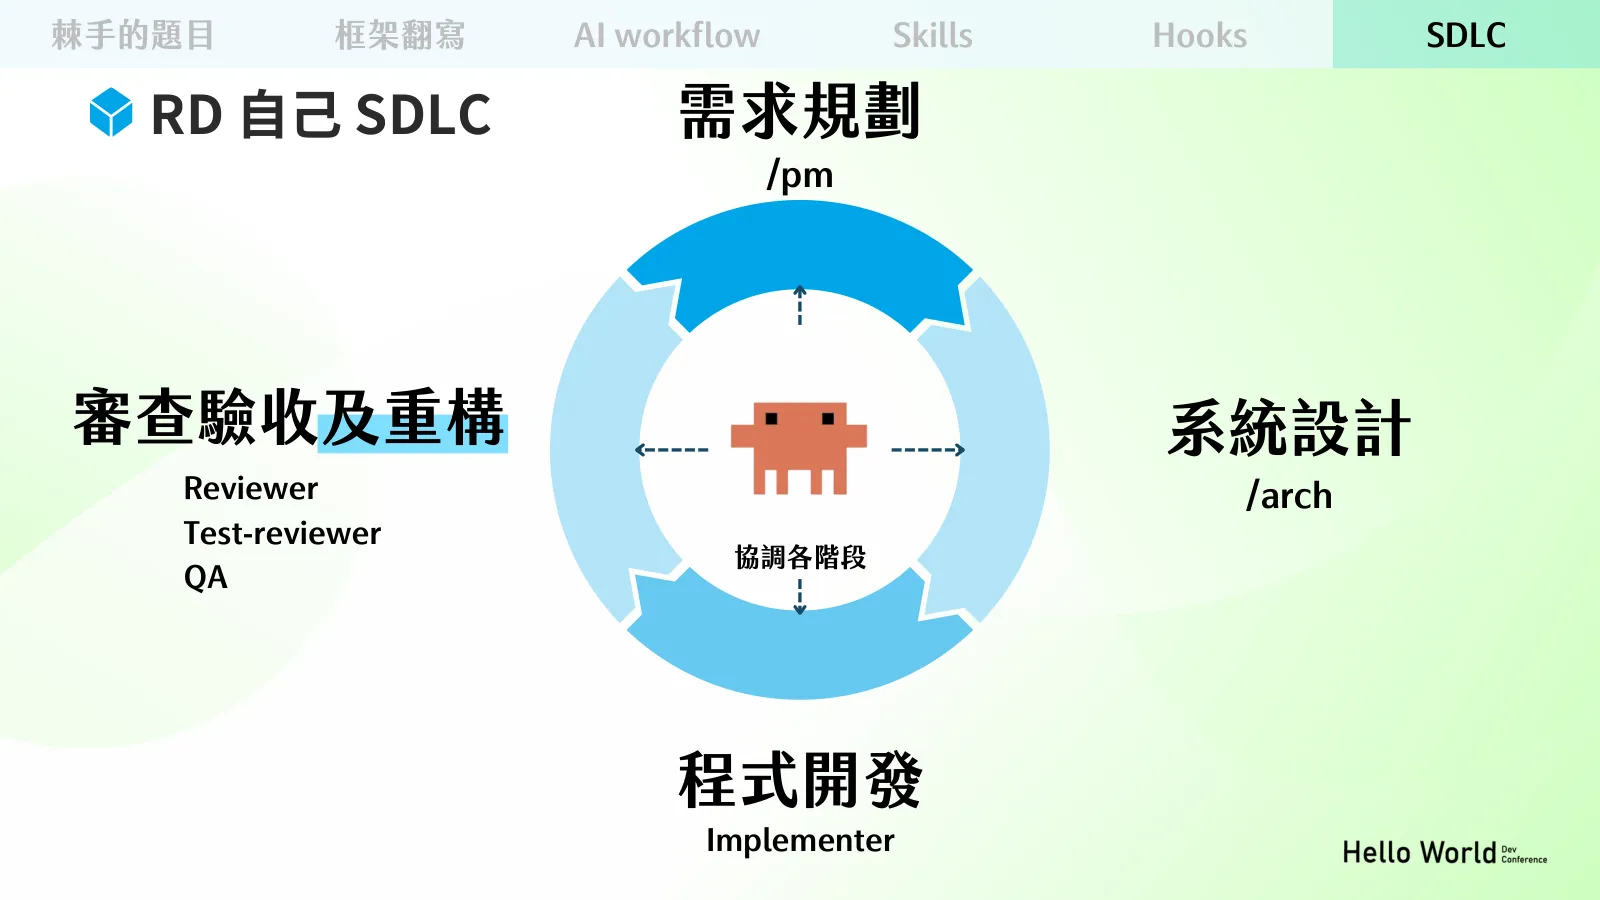
前面講了這麼多 workflow 或是 harness 的設計,我想表達的是:原本 SDLC 是整個團隊一起跑,每個人分工合作,但有了 AI 之後,RD 跟 AI 協作的工作流迴圈,剛好可以對應到 SDLC 的階段。也就是 SDLC 除了整個團隊一起跑,也能縮小到 RD 跟 AI 協作的過程,提升 AI 產出的可用性與品質
如果要用一句話貫穿整場分享
最後,如果要用一句話貫穿我在這場演講中分享的所有設計,我認為是:
假設 AI 什麼都知道,但他也什麼都不知道
AI 很會寫 code,也知道 design pattern,或是前面那些測試方法,你問 AI 他肯定都知道,我並不需要教他這些內容。但它雖然知道這些,卻沒辦法在「真正寫測試的時候」好好的應用這些方法
同樣他也不知道使用者預期會怎麼操作、測試要怎麼測才會真的模擬使用者操作,或是服務的規模多大來去決定我要怎麼設計,或是團隊的 coding style 等等的,這些都是需要人告訴他的
所以我認為在設計 AI workflow 時,要「假設 AI 什麼都知道,但他也什麼都不知道」,去想哪些東西還藏在自己腦裡、沒講清楚讓 AI 知道
總結
總結一下,我在翻寫案跟 AI 協作下來,可以分享給大家的是:
- 想像力就是超能力:跟 AI 協作時盡可能描述目標與意圖,避免成為 AI 的限制器。我也聽過很多前輩分享,原本告訴 AI 要走某個方法,後來改成不講做法、只描述意圖,AI 做出來的方法反而讓他學到原來可以這樣做
- 善用 hooks、skills、MCP 等機制來控制 AI 的輸出,因為 AI 畢竟是非確定性的,但程式碼跑出來的結果是確定的
- SDLC 最常被忽略的測試,是 AI 時代最不該被忽略的
- 透過撰寫測試保護行為,在開發後接著重構,維持程式品質
- AI 什麼技術都會,但它也不知道使用者的需求、團隊的風格,這些是你必須告訴 AI 的
以上就是昨天的分享啦!完整簡報放在文末,如果後續大家有興趣跟有更多交流,歡迎追蹤我的臉書,我比較常在臉書活躍